Crawl4AI 0.9.5 上手:用 AsyncWebCrawler 把网页抓成 Markdown,用 CSS 规则提取结构化 JSON,再做深度爬取、批量抓取、截图导出和命令行
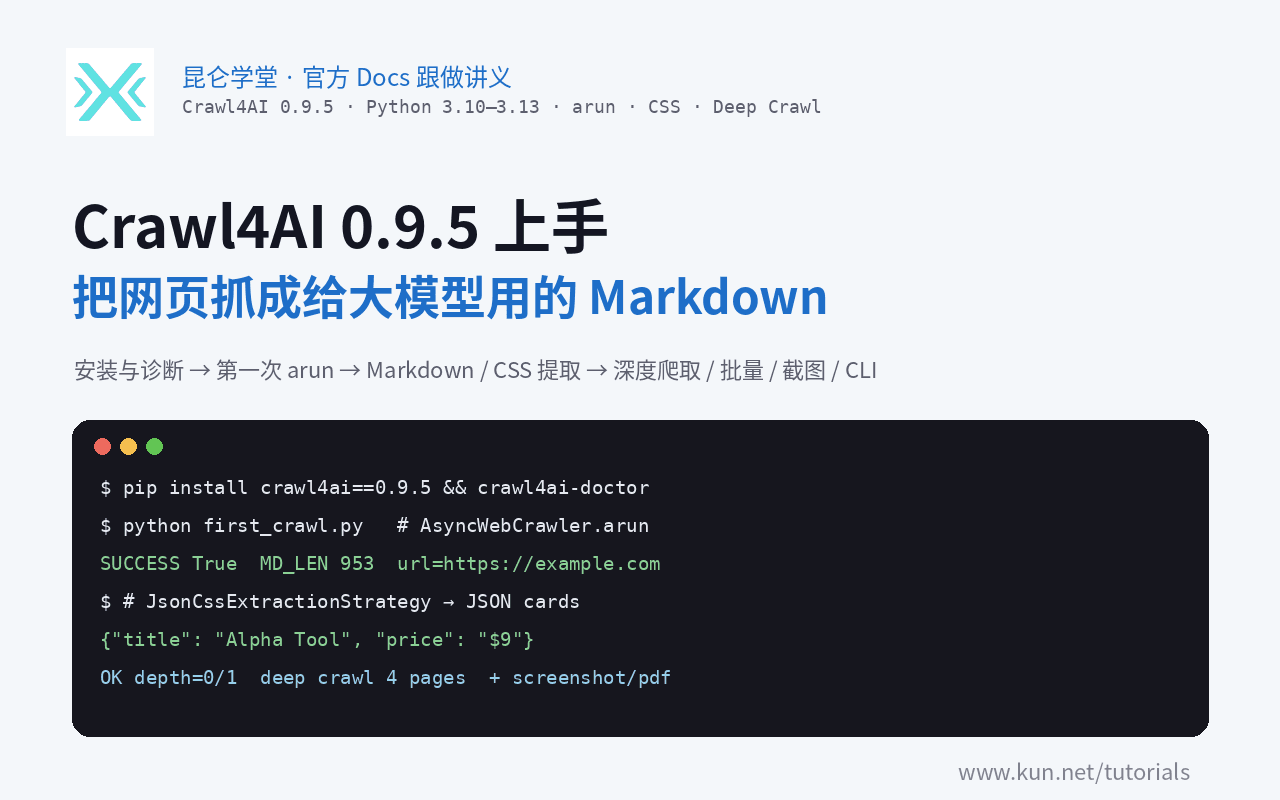
按 Crawl4AI 官方 Docs Quick Start、Installation、CLI 与 Deep Crawling(0.9.5 实测):在虚拟环境里装好 crawl4ai 并跑通 crawl4ai-doctor;用 AsyncWebCrawler.arun 把 https://example.com 抓成 Markdown;用 CrawlerRunConfig 与 CacheMode.BYPASS 抓官方文档页、对比 raw / fit Markdown,再用 JsonCssExtractionStrategy 从 raw HTML 抽出 JSON;接着做 BFS 深度爬取、arun_many 批量抓取、截图与 PDF 导出,并用 crwl 命令行复现;LLM 提取、Docker / Cloud MCP 按官方说明整理并标注未实测。
入门·3 课时·65 分钟·图文实操
免费学习无需登录
你将学会
- 安装 Crawl4AI 并跑通诊断
- 用 arun 把网页抓成 Markdown
- 用 CSS 规则提取结构化 JSON
- 对比 raw 与 fit Markdown
- 做深度爬取和批量抓取
- 用命令行与截图 / PDF 导出
适合谁
- 要给 RAG 或智能体准备网页语料的人
- 搭本地爬虫流水线的开发者
- 想用开源工具代替托管抓取 API 的人
课前准备
- 会用终端和 pip
- 能看懂简单的 Python asyncio
- Python 3.10 至 3.13
课程目录
3 课时 · 65 分钟- 01装好 Crawl4AI,跑通诊断,第一次把网页抓成 Markdown在虚拟环境里安装 crawl4ai==0.9.5,运行 crawl4ai-setup 与 crawl4ai-doctor,再用 AsyncWebCrawler.arun 抓 https://example.com,看懂 success、Markdown 长度和正文节选。图文20 分钟开始本课
- 02配置缓存与 Markdown 过滤,用 CSS 规则提取结构化 JSON用 BrowserConfig 与 CrawlerRunConfig(CacheMode.BYPASS)抓官方 Quick Start 文档页,对比 raw Markdown 与 PruningContentFilterLXML 过滤后的 fit Markdown;再用 JsonCssExtractionStrategy 从 raw HTML 抽出多条卡片 JSON,弄清 schema 字段怎么写。图文25 分钟开始本课
- 03深度爬取、批量抓取、截图导出与命令行;MCP 与 LLM 提取怎么接用 BFSDeepCrawlStrategy 从官方安装文档做一层深度爬取并读 metadata.depth;用 arun_many 并发抓多个 URL;打开 screenshot 与 pdf 导出;用 crwl 命令行复现;LLMExtractionStrategy 与 Docker / Cloud MCP 按官方说明整理并标图文20 分钟开始本课
课程说明
Crawl4AI 是新加坡开发者 UncleCode 发起的 Apache-2.0 开源网页爬虫(GitHub 约 8.7 万星),专门为大模型、RAG 和 AI 智能体准备数据。它用 Playwright 驱动真实浏览器,把网页转成干净 Markdown,也能按 CSS / XPath 规则或大模型 schema 抽出结构化 JSON。2026 年 10 月 14 日发布的 0.9.5 版支持 Python 3.10 至 3.13;另有命令行 crwl、深度爬取、截图 / PDF 导出,以及可选的 Docker 自建服务与托管 Cloud API / MCP。
本课按 Crawl4AI 官方文档的 Installation、Quick Start、CLI,以及 Deep Crawling 相关说明整理。2026-11-06 在一台 Linux x86_64 云主机上,用 Python 3.13.5 的虚拟环境安装 crawl4ai 0.9.5,跑通 crawl4ai-doctor,实跑了 AsyncWebCrawler.arun、带 PruningContentFilterLXML 的 Markdown 生成、JsonCssExtractionStrategy、BFSDeepCrawlStrategy、arun_many、截图与 PDF 导出,以及 crwl 命令行。「对照结果」都是真实输出,只做了节选。LLMExtractionStrategy(需要 API Key 或本机 Ollama)、Docker 自建 MCP(端口 11235)和 Crawl4AI Cloud 远程 MCP,测试机没有对应密钥或 Docker 环境,按官方说明整理,课内单独注明「未实测」。
| 课时 | 你会做完的事 | 需要什么 |
|---|---|---|
| 1 | 装好 Crawl4AI,跑通诊断,用 arun 把 https://example.com 抓成 Markdown | 终端,Python 3.10 至 3.13 |
| 2 | 配置缓存与 Markdown 过滤,对比 raw / fit,再用 CSS 规则抽出 JSON | 同上,会一点 Python |
| 3 | 做一层深度爬取、批量抓多个 URL、导出截图与 PDF,并用 crwl 复现 | 同上;可选 Docker 与 LLM API Key |
适合
- 要把网页转成 Markdown 再喂给大模型或 RAG 的人
- 搭本地爬虫流水线、想先跑通开源方案的开发者
- 想用 CSS 规则稳定抽列表数据、必要时再接大模型提取的人
先修
- 会用终端和 pip
- 能看懂简单的 Python 与
asyncio - 本机有 Python 3.10 至 3.13
你会学到
- 用 pip 安装 crawl4ai 0.9.5,跑
crawl4ai-setup与crawl4ai-doctor - 用
AsyncWebCrawler和arun抓一个页面并读取result.markdown - 用
BrowserConfig、CrawlerRunConfig、CacheMode.BYPASS控制浏览器与缓存 - 用
DefaultMarkdownGenerator加PruningContentFilterLXML得到更干净的 fit Markdown - 用
JsonCssExtractionStrategy按 schema 抽出 JSON(含raw://HTML) - 用
BFSDeepCrawlStrategy、arun_many、截图 / PDF 与crwl命令行做更深一层的抓取
官方资料
- 文档首页:https://docs.crawl4ai.com/
- Quick Start:https://docs.crawl4ai.com/core/quickstart/
- Installation:https://docs.crawl4ai.com/core/installation/
- CLI:https://docs.crawl4ai.com/core/cli/
- Self-Hosting / MCP:https://docs.crawl4ai.com/core/self-hosting/
- GitHub:https://github.com/unclecode/crawl4ai
- PyPI:https://pypi.org/project/crawl4ai/
- 官网(含 Cloud 定价):https://crawl4ai.com/
绑定工具: Crawl4AI(https://www.kun.net/tools/crawl4ai/ )