Docling 2.148 上手:本地把 PDF、Word、HTML 转成 Markdown 与 JSON,导出表格 CSV,用 HybridChunker 切块做 RAG,再接成 MCP 工具
按 Docling 官方 Installation、Quickstart、CLI reference、Chunking 与 docling-mcp README(2.148.0 实测):在 Linux CPU 环境装好 docling,用 docling convert 把 9 页技术报告 PDF 转成 Markdown 并对比开关 OCR(48.89 秒对 9.74 秒);只转指定页、导出 JSON、用 Python API 把表格存成 CSV、转换 HTML;用命令行 chunks 输出与 HybridChunker 按标题和 token 上限切块;最后用 uvx 拉起 docling-mcp 3.5.0(stdio、本机模式),用最小客户端列出 21 个工具并完成一次转换。
入门·3 课时·70 分钟·图文实操
免费学习无需登录
你将学会
- 安装 Docling 并确认版本
- 用命令行把 PDF 转成 Markdown
- 关 OCR 与图片占位提速
- 导出 JSON 与表格 CSV
- 用 HybridChunker 切块做 RAG
- 把 Docling 接成 MCP 工具
适合谁
- 要把 PDF 和 Office 文档喂给大模型的开发者
- 想在本机处理敏感文档的团队
- 需要抽表格并保留页码溯源的人
课前准备
- 会用终端和 pip 或 uv
- 能看懂简单的 Python
- Python 3.10 及以上
课程目录
3 课时 · 70 分钟- 01装好 Docling,用命令行把 PDF 转成 Markdown,并对比开关 OCR用 uv 或 pip 安装 docling 2.148.0(Linux 无显卡用 CPU 版 torch),确认版本;下载官方技术报告 PDF,用 docling convert 转成 Markdown,再关 OCR、图片改占位符,看耗时从 48.89 秒降到 9.74 秒、体积从 570 KB 降到 29 KB。图文20 分钟开始本课
- 02只转指定页、导出 JSON 与表格 CSV,用 Python API 定制转换用页码范围只转第 3 到 5 页并同时导出 Markdown 与 JSON,看懂 DoclingDocument 里的文字类型与页脚;用 DocumentConverter 与 PdfPipelineOptions 关 OCR、保留表格识别,把表格导出成 CSV;再把官方安装文档 HTML 转成 Markdown。图文25 分钟开始本课
- 03用 HybridChunker 切块做 RAG,再把 Docling 接成 MCP 工具用命令行 chunks 输出直接得到带标题、页码的 JSONL;在 Python 里用 HybridChunker 指定分词器与 token 上限,对比 128 与 512 上限的块数;最后用 uvx 以 stdio 本机模式拉起 docling-mcp 3.5.0,用官方 mcp SDK 列出 21 个工具并完成一次转换。图文25 分钟开始本课
课程说明
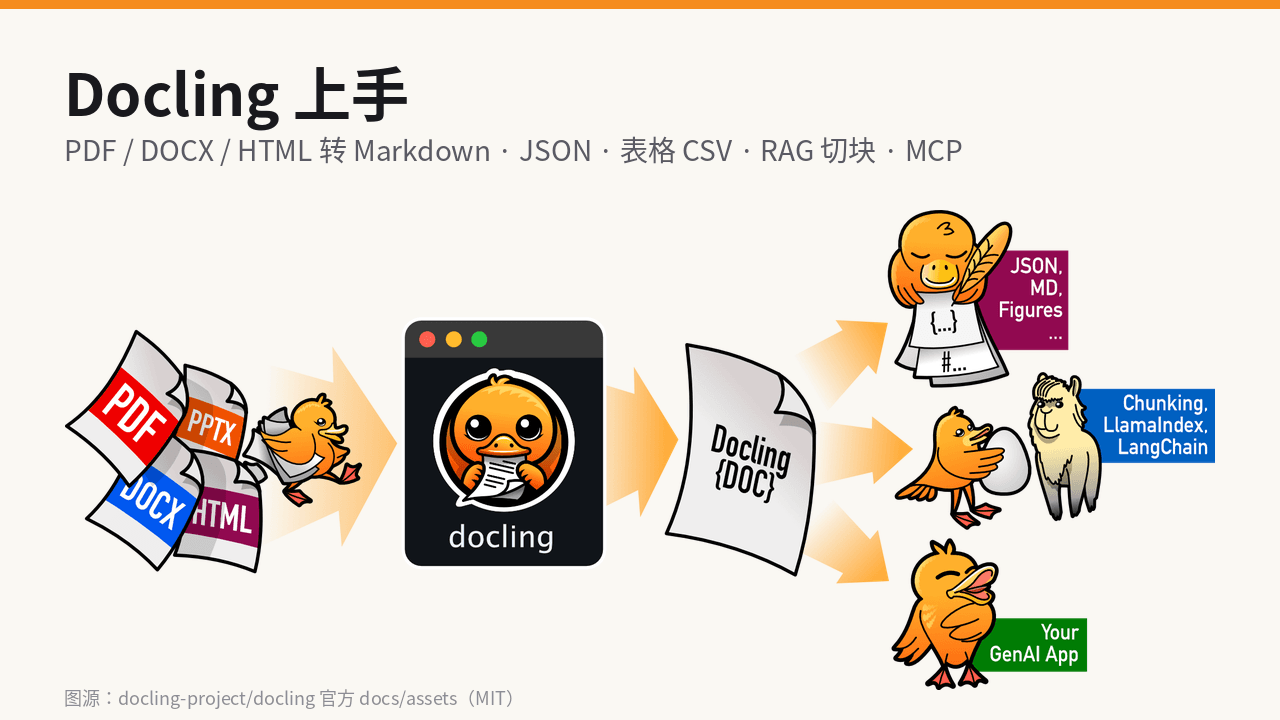
Docling 是 IBM Research 苏黎世实验室发起、现由 LF AI & Data 基金会托管的 MIT 开源文档解析工具(GitHub 约 7 万星),专门把 PDF、Word、PPT、Excel、HTML、图片等文档转成生成式 AI 好用的结构化数据。它在本机用版面分析模型和 TableFormer 表格模型读懂标题层级、阅读顺序和表格,统一成 DoclingDocument,再导出 Markdown、无损 JSON、HTML 或 RAG 用的切块。2026 年 11 月 5 日发布的 2.148.0 版把命令行整理成 docling convert 子命令,另有官方 MCP 服务 docling-mcp。
本课按 Docling 官方文档的 Installation、Quickstart、CLI reference、Supported formats、Chunking 与 Hybrid chunking 示例、Export tables 示例,以及 docling-mcp README 整理。2026-11-08 在一台没有 GPU 的 Linux x86_64 云主机上,用 Python 3.12.15 虚拟环境安装 docling 2.148.0(CPU 版 torch 2.15.0),全部命令和代码都实跑过:PDF 转 Markdown(开、关 OCR 对比)、只转指定页、导出 JSON、表格转 CSV、HTML 转换、命令行切块与 HybridChunker、换 bge-m3 分词器,以及用官方 mcp Python SDK 以 stdio 方式拉起 docling-mcp 3.5.0、列出 21 个工具并完成一次转换。「对照结果」都是真实输出,只做了节选。没有实测的只有两项:中文扫描件 OCR 与 DOCX 输入(测试机没有现成文件),课内已注明。
| 课时 | 你会做完的事 | 需要什么 |
|---|---|---|
| 1 | 装好 Docling,用命令行把 9 页技术报告 PDF 转成 Markdown,对比开、关 OCR 的耗时与体积 | 终端,Python 3.10 及以上,约 2 GB 磁盘 |
| 2 | 只转指定页、同时导出 Markdown 与 JSON;用 Python API 把表格存成 CSV;转换 HTML 网页 | 同上,会一点 Python |
| 3 | 命令行直接输出 chunks,用 HybridChunker 控制分词器与 token 上限;把 Docling 接成 MCP 服务并验证 | 同上;可选 uv、Claude Desktop 等 MCP 客户端 |
适合
- 要把 PDF、Office 文档喂给大模型或 RAG 的开发者
- 想在本机或内网处理敏感文档、不想上传云端解析服务的团队
- 需要从报告里抽表格、保留页码做引用溯源的人
先修
- 会用终端和 pip(或 uv)
- 能看懂简单的 Python
- 本机有 Python 3.10 及以上
你会学到
- 用 pip 或 uv 安装 Docling(Linux 无显卡用 CPU 版 torch)
- 用
docling convert把 PDF 转成 Markdown,并用关 OCR、图片占位提速瘦身 - 只转指定页,一次导出 Markdown 和 JSON,看懂 DoclingDocument 结构
- 用
DocumentConverter与PdfPipelineOptions定制转换,把表格导出为 CSV - 用命令行与
HybridChunker按结构和 token 上限切块,拿到带标题、页码的 RAG 文本 - 用 docling-mcp 把 Docling 接成 MCP 工具,并用最小客户端验证
官方资料
- 文档首页:https://docling-project.github.io/docling/
- Installation:https://docling-project.github.io/docling/getting_started/installation/
- Quickstart:https://docling-project.github.io/docling/getting_started/quickstart/
- CLI reference:https://docling-project.github.io/docling/reference/cli/
- Supported formats:https://docling-project.github.io/docling/usage/supported_formats/
- Chunking:https://docling-project.github.io/docling/concepts/chunking/
- MCP:https://docling-project.github.io/docling/usage/mcp/
- GitHub:https://github.com/docling-project/docling
- docling-mcp:https://github.com/docling-project/docling-mcp
- PyPI:https://pypi.org/project/docling/
绑定工具: Docling(https://www.kun.net/tools/docling/ )