第 3 课
传入官方示例 PDF,做多轮会话并认识隐式缓存
把官方示例 PDF 交给模型做摘要,继续多轮会话,并认识隐式缓存
课程目录第 3 / 3 课
学习位置仅保存在当前浏览器,有效期 180 天。
图文教材
本课对照官方文档「文档理解」「Getting started」「Interactions API 概览」「上下文缓存」编写。PDF 示例地址和多轮会话代码来自官方文档;成功摘要和缓存命中数字采用官方说明,本环境未用真实密钥跑出成功回复。2026-11-20 核对。
本课目标
- 按官方文档把一份公开 PDF 交给
gemini-4-neon做摘要 - 用
previous_interaction_id继续同一段会话 - 认识 Neon 只支持隐式缓存,以及缓存命中后的刊例价
- 知道默认会存储 Interaction,以及何时改用
store=false
前置条件
- 已完成第 1 课和第 2 课,当前终端里仍有有效的
GEMINI_API_KEY - 已安装
google-genai - 本机还能安装
httpx,用于按官方示例下载远程 PDF - 能访问官方示例使用的 arXiv 地址
第 1 步:先确认官方示例文档能打开
官方「文档理解」在「Large PDFs from URLs」一节使用下面这份公开 PDF,作为大文档示例:
https://arxiv.org/pdf/2312.11805
这是 arXiv 上的 Gemini 技术报告(编号 2312.11805)。先在浏览器或终端确认能下载,再发给模型。不要改用未经核对的其他地址来顶替这一步。
curl -L -o gemini-paper.pdf "https://arxiv.org/pdf/2312.11805"
ls -lh gemini-paper.pdf
你应看到一个体积不是空文件的 PDF。具体字节数会随 arXiv 当时提供的文件变化,本课不把它写成必须一致的校验和。
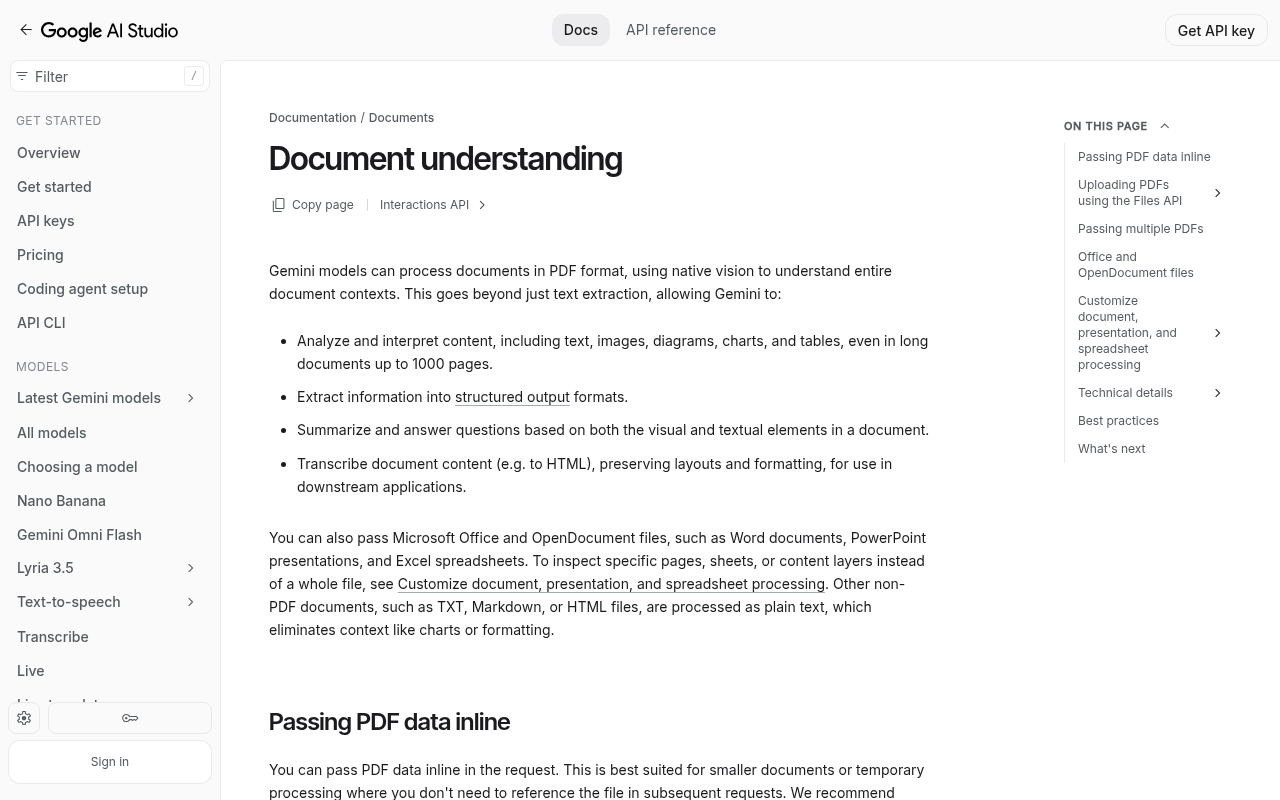
2026-11-20 实拍。
第 2 步:按官方示例上传 PDF 并请求摘要
官方这一节的 Python 示例通过 File API 上传远程 PDF,再把文件 URI 传给 Interactions API。示例原文使用 gemini-4-hydrogen。本课按「迁移到 Neon」的说明,只把 model 改成 gemini-4-neon,其余流程保持官方原样。
官方示例依赖 httpx。若尚未安装:
pip install httpx
新建 summarize_pdf.py:
from google import genai
import io
import httpx

client = genai.Client()

long_context_pdf_path = "https://arxiv.org/pdf/2312.11805"

doc_io = io.BytesIO(httpx.get(long_context_pdf_path).content)

sample_doc = client.files.upload(
    file=doc_io,
    config=dict(mime_type="application/pdf")
)

prompt = "Summarize this document"

interaction = client.interactions.create(
    model="gemini-4-neon",
    input=[
        {
            "type": "document",
            "uri": sample_doc.uri,
            "mime_type": sample_doc.mime_type,
        },
        {"type": "text", "text": prompt},
    ],
)
print(interaction.id)
print(interaction.output_text)
python summarize_pdf.py
这是一次计费调用。官方定价页还写明:DOCUMENT 模态(例如 PDF)的 tokens 按图片 tokens 费率计费,并出现在响应 promptTokensDetails 的 DOCUMENT 项里。PDF 本身加上默认 high 思考档,费用会明显高于第 1 课的短文本请求。若只想先确认上传是否成功,可以把 thinking_level 临时设为 low,但那是你自己的调整,不是官方这一节的默认写法。
官方这一页没有给出该 PDF 的固定摘要文本,本课也不编造。成功时,你应得到一个 interaction.id,以及一段针对该文档的摘要;失败时先检查 Key、付费层、网络能否下载该 PDF,以及 httpx 是否已安装。
采用官方文档示例,本环境未用真实密钥跑出成功回复。
第 3 步:用 previous_interaction_id 继续提问
官方「Getting started」把带服务端状态的多轮会话写为推荐做法:第一次请求完成后,把返回的 id 作为下一次请求的 previous_interaction_id,不必把全部历史再发一遍。
下面在第 2 步的摘要之后,追加一轮追问。官方多轮示例原文使用 gemini-4-hydrogen 和另一组提示;这里保持同样的参数结构,只把模型改成 gemini-4-neon,并接上你刚得到的文档摘要会话:
from google import genai

client = genai.Client()

# 把上一轮打印出的 interaction.id 填在这里
previous_id = "v1_REPLACE_WITH_YOUR_INTERACTION_ID"

followup = client.interactions.create(
    model="gemini-4-neon",
    input="List the paper's main contributions in 5 bullet points.",
    previous_interaction_id=previous_id,
)

print(followup.output_text)
官方强调:previous_interaction_id 只保留对话历史(输入和输出)。tools、system_instruction 和 generation_config(包括 thinking_level)只对当前这一次请求生效。如果你在上一轮设过思考档,这一轮还要再写一遍,否则会回到型号默认值。对 Neon 来说,默认值是 high。
官方「Getting started」用“I have 2 dogs in my house.”和“How many paws are in my house?”演示同一机制。本课把这个机制接到文档摘要之后,方便你核对模型是否还记得上一轮的 PDF。官方没有给出这两段追问的固定样例回复,本课也不编造。
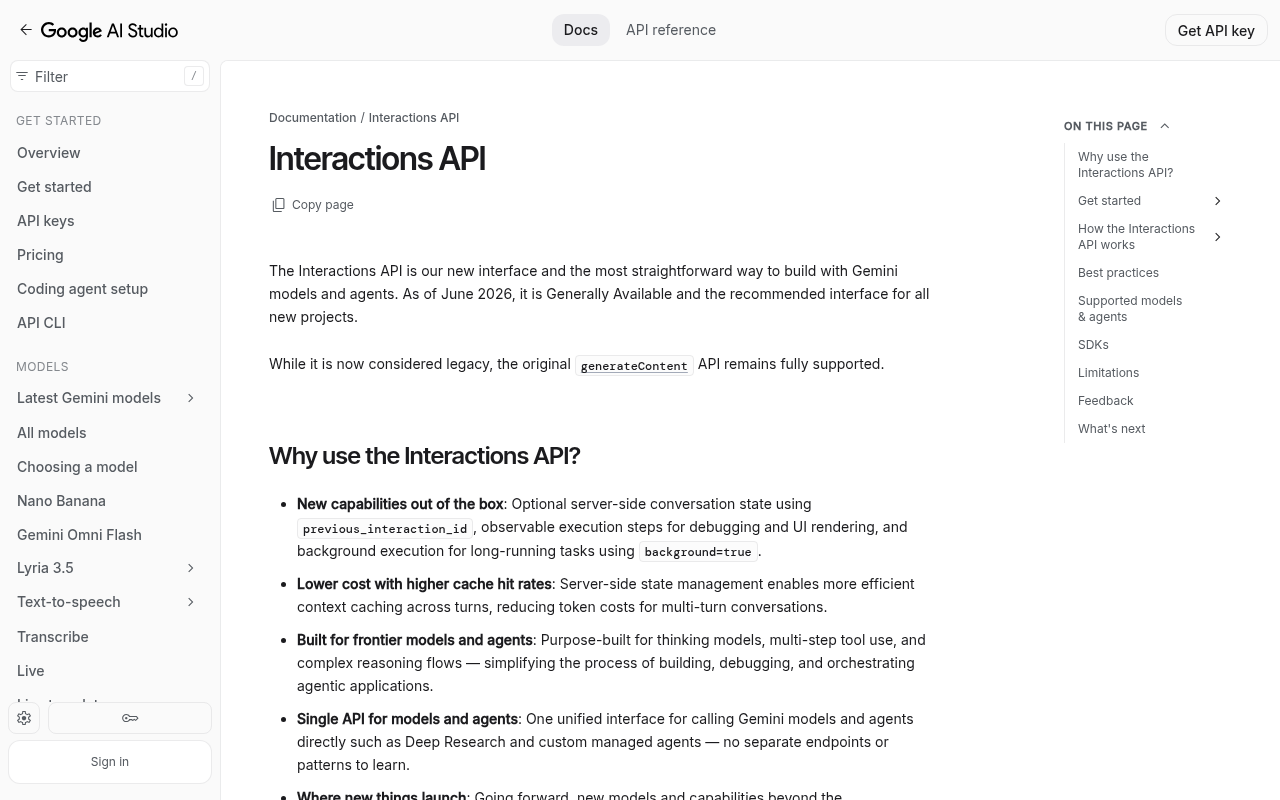
2026-11-20 实拍。
第 4 步:认识隐式缓存,不要再调用显式缓存
官方「上下文缓存」写明:Interactions API 以及所有 Gemini 4 型号都只支持隐式缓存,不支持显式缓存(cachedContents 和 caches.create)。若请求里还带着 cached_content 字段,应删掉。隐式缓存默认开启,只要请求命中缓存,官方就会把节省下来的费用返还,你不必再单独打开开关。
对 Gemini 4 Neon,隐式缓存的最小输入长度是 4,096 tokens。官方定价页写明:缓存输入打 5% 的价格,也就是每 100 万 tokens $0.15。要提高命中机会,官方建议:
- 把较大、且多次重复使用的内容放在提示的开头
- 在较短时间内发送前缀相似的请求
- 多轮会话优先用
previous_interaction_id,让服务端更容易复用历史前缀
另外还有一条针对 Gemini 4 多轮和智能体循环的规则:只有当新请求至少新增 2,050 tokens 时,模型才会把上一轮完整请求缓存下来。模型输出、思考和函数结果都计入这个增量。增量更小时,Gemini 会按标准输入价重新处理上一轮最后 2,050 tokens。官方称大多数智能体回合会超过这个阈值。
缓存命中的 token 数写在响应的 usage.total_cached_tokens 里(Python 与 JavaScript 字段名相同)。本环境没有用真实密钥跑出缓存命中,因此不编造该字段的数字。你用自己的付费额度、并在提示达到 4,096 tokens 之后,应在第二次及以后的相似请求里核对该字段。
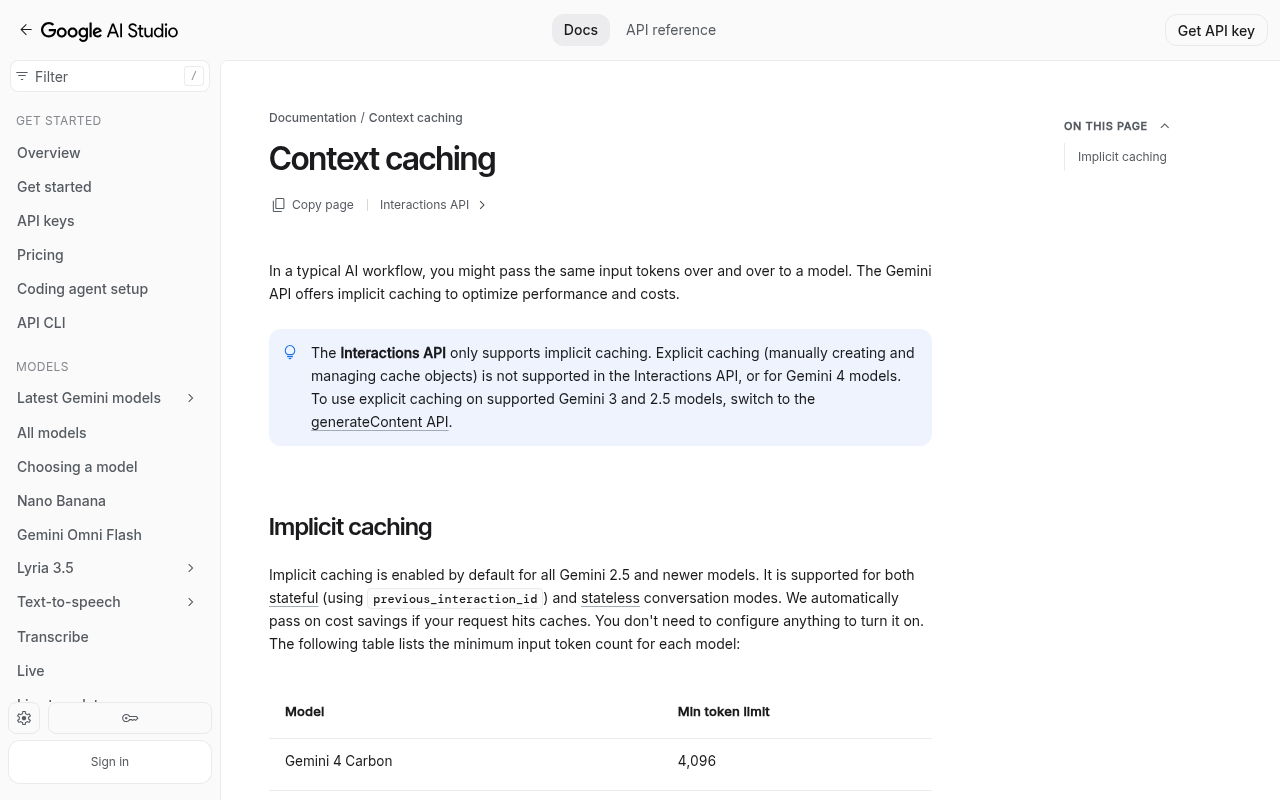
2026-11-20 实拍。页中表格列出 Gemini 4 Neon 的最小缓存长度是 4,096 tokens。
第 5 步:了解默认存储,以及何时关闭
默认情况下,Interactions API 会存储请求(store=true),以便使用 previous_interaction_id、后台执行和日志查看。官方写明:付费层会把 Interaction 保留 55 天,免费层保留 1 天。Neon 只在付费层提供,因此走的是 55 天这一档。付费项目还可以在 AI Studio 里把保留期配置为 7、14、28 或 55 天。
如果你不希望保存某一次请求,可以在创建时加上 store=false。官方同时提醒:store=false 与后台执行不兼容,也不能再把这次结果当作后续回合的 previous_interaction_id。需要删除已存储的 Interaction 时,可按官方文档使用 delete 方法,或在 AI Studio 的 Logs 页管理。
日常跟做文档摘要和多轮追问,保持默认的 store=true 即可。
常见坑
- 把显式缓存的旧字段继续传给 Neon。Gemini 4 和 Interactions API 都不支持显式缓存。
- 忘记在每一轮重新传入
generation_config。思考档不会随着previous_interaction_id自动继承。 - 用只有几百 tokens 的短提示去「验证」隐式缓存。Neon 的最小缓存长度是 4,096 tokens,短请求不会命中。
- 把
store=false和background=true或后续多轮会话写在一起。官方写明这两者不兼容。 - 在网络无法访问 arXiv 时,改用一份来源不明的本地 PDF,却仍把结果当成官方示例对照。请先解决下载问题,或明确写明你改用了哪一份自己的文件。
小结
这一课你已经按官方文档把公开 PDF 交给 Neon,会用 previous_interaction_id 继续提问,并知道隐式缓存的最小长度、刊例价和字段名。把三课合在一起,就完成了从第一个请求、思考档到多模态文档与缓存的入门路径。更复杂的函数调用、Google Search 接地和托管智能体,请继续对照官方对应指南跟做,不要把未核对的二手步骤写进生产代码。