第 3 课
把可复用说明放进缓存前缀,再跟做一次官方工具调用
> 本课对照官方文档「Using GPT-6.2」「提示缓存」「函数调用」编写。缓存请求形状来自官方「Single-turn LLM-as-a-Judge」示例,工具调用代码来自官方 `get_horoscope` 示例。2026-11-19 核对。
课程目录第 3 / 3 课
学习位置仅保存在当前浏览器,有效期 180 天。
图文教材
本课对照官方文档「Using GPT-6.2」「提示缓存」「函数调用」编写。缓存请求形状来自官方「Single-turn LLM-as-a-Judge」示例,工具调用代码来自官方
get_horoscope示例。2026-11-19 核对。
本课目标
- 理解 GPT-6.2 对顶层
instructions的新处理方式 - 把可复用说明放到
input开头的developer消息中,让它有资格进入缓存前缀 - 对照官方的最短前缀、TTL 和缓存读写费率
- 按官方五步流程完成一次函数调用
- 迁到 GPT-6.2 时去掉官方列出的不支持参数
前置条件
- 已完成第 1 课和第 2 课,当前终端里仍有有效的
OPENAI_API_KEY - 已安装
openai包 - 工具调用必须使用 Responses API,不要改回 Chat Completions
第 1 步:先看 GPT-6.2 对 instructions 的变化
「Using GPT-6.2」写了两条会直接影响旧集成的变化。
第一,从 GPT-6.2 开始,如果对话中途改了历史前缀(prefix edits)、做了某些型号切换(包括降级),或更改了终端用户或组织,Responses API 会丢掉推理项。一旦模型拿不到这些推理项,回答质量可能下降,并可能用更多 tokens 重复前面的工作。要保留推理、并让更早的输入继续有资格命中提示缓存,请在两次响应之间保持前缀不变。
第二,从 GPT-6.2 开始,Responses API 会把顶层 instructions 追加到 input 之后。官方「提示缓存」也写明:这些 tokens 即使在缓存命中时,也按未缓存的输入费率计费。若要让可复用说明进入缓存前缀,把它们放到 input 的第一条 developer 消息里。顶层 instructions 只留给「仅对当前这一次请求有效」的说明。
这不是风格建议,而是计费和缓存行为的变化。旧代码如果一直把系统提示写在 instructions 里,迁到 GPT-6.2 后,这段提示将不再作为可缓存前缀的一部分。
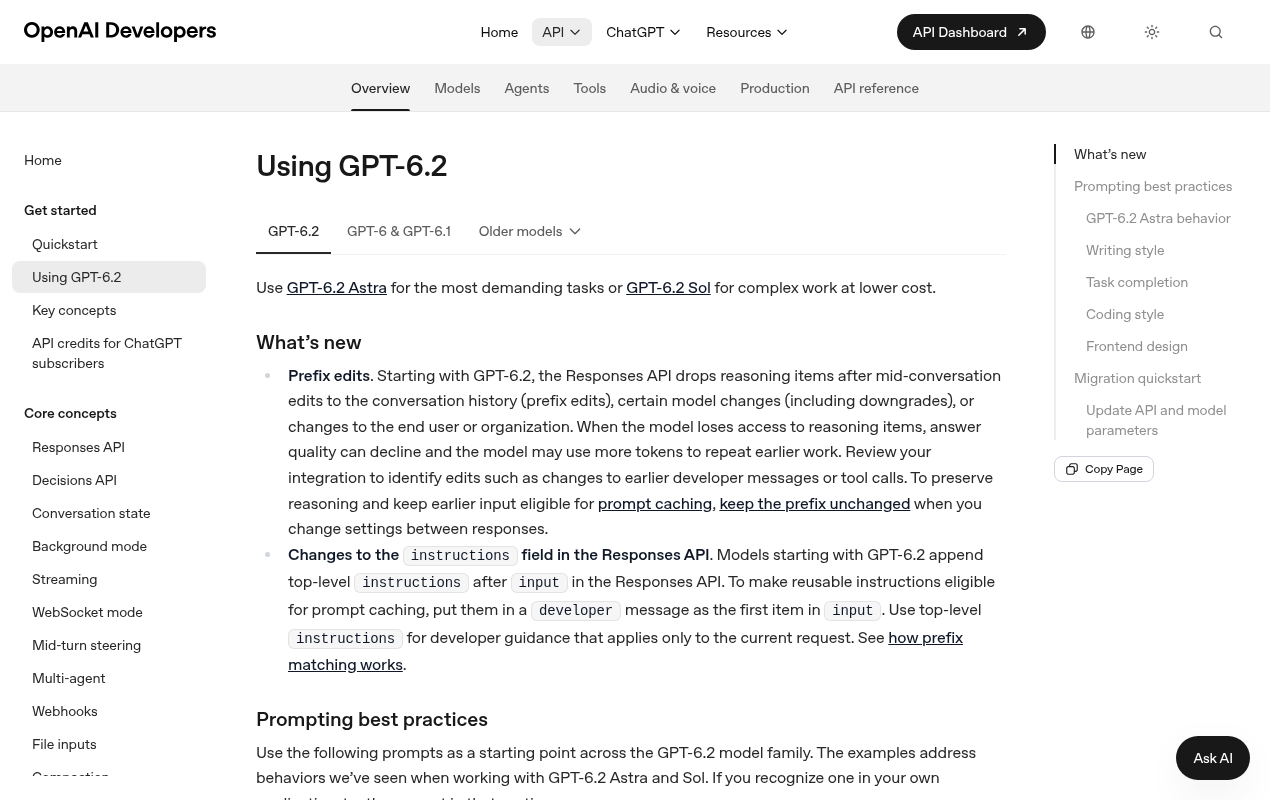
同一页在第 2 课已经见过首屏,这里再对照阅读「What's new」。
第 2 步:把可复用说明放到第一条 developer 消息
下面是按官方迁移说明整理的请求形状:稳定说明放在 input 开头,只对这一轮有效的要求才放进顶层 instructions。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Summarize findings for this turn only.",
    input=[
        {
            "role": "developer",
            "content": (
                "You are a careful code reviewer. "
                "Follow the project's existing style."
            ),
        },
        {
            "role": "user",
            "content": "Review the latest diff and list blocking issues.",
        },
    ],
)

print(response.output_text)
这段 Python 用来演示官方要求的字段位置,不是官方逐字拷贝的完整示例。其中的说明文字也短于可缓存阈值,第一次请求不会因此创建可复用前缀。真正要命中缓存时,请看下一步的官方规则和第 4 步的官方 JSON。
第 3 步:对照最短前缀、TTL 和费率
提示缓存默认开启。官方把收益写成三点:少重复计算前缀、缓存命中的输入更便宜、以及更快开始生成。缓存里保存的是前缀对应的中间状态,不是把 tokens 原文再存一份。要命中缓存,后续请求的整个已渲染前缀必须一致。
对 GPT-5.6 及以后的型号(包括 GPT-6.2),官方「模型差异摘要」给出这些规则:
- 可缓存前缀最短为 1,024 个可见输入 tokens
- 默认 TTL 是
"30m",在 Responses API 里也可以设"12h",参数是prompt_cache_options.ttl - 从更早型号迁来时,用
prompt_cache_options.ttl替代旧的prompt_cache_retention;常见迁移写法是先设"30m" - 缓存命中费率一般为未缓存输入的 0.1 倍;GPT-6.2 Astra、GPT-6.2 Sol、GPT-6.1 Sol 和 GPT-6.1 Terra 为 0.05 倍
- 写入费率:
"30m"为未缓存输入的 1.25 倍,"12h"为 2.5 倍 - 写入费不是在输入费之外再加一笔:输入 tokens 分别按未缓存、缓存命中或缓存写入三者之一计费
这与本轮核对的刊例价一致。以短上下文 Standard 为例:Sol 输入 $2.00、命中 $0.10、30 分钟写入 $2.50;Astra 输入 $8.00、命中 $0.40、30 分钟写入 $10.00。
看一次请求有没有写缓存或命中缓存,应检查 usage.input_tokens_details 里的 cached_tokens 和 cache_write_tokens。官方「推理模型」页给出的 usage 示例里,cached_tokens 为 0,那是还没有命中缓存的情况。
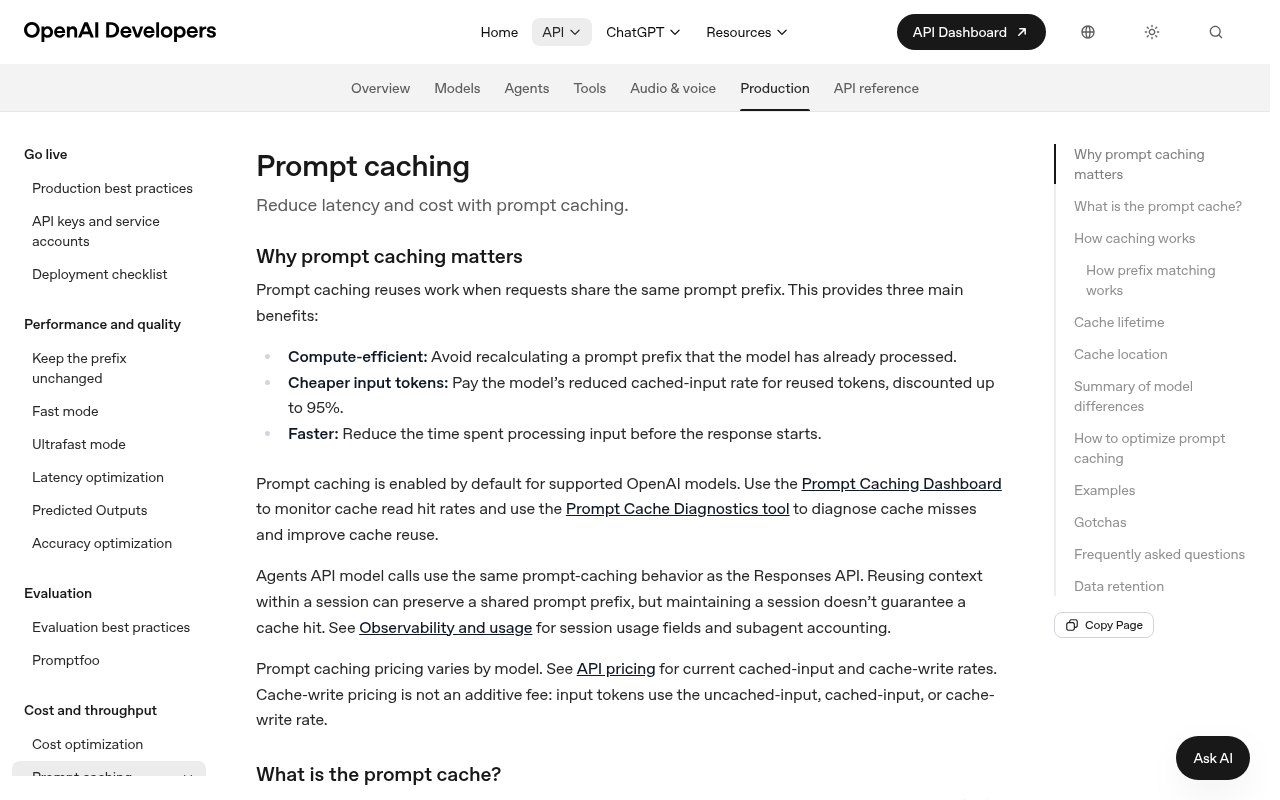
2026-11-19 实拍。
https://developers.openai.com/api/docs/guides/prompt-caching
第 4 步:抄写官方的显式缓存请求形状
官方「提示缓存」用一个单轮评审(LLM-as-a-Judge)例子说明显式缓存:固定的评分标准和少量示例放在前面,并在其后打断点;每次要评审的对话放在断点之后,避免为不太可能复用的内容支付写入费。文档把评分标准和示例写成了省略句,因此下面这段是官方公布的请求形状,不是一份已经超过 1,024 tokens 的可直接计费前缀。真用时,需要把 "Full grading rubric and labeled few-shot examples..." 换成你自己足够长、且会反复使用的材料。
{
  "model": "gpt-6.2-sol",
  "reasoning": { "effort": "medium", "context": "all_turns" },
  "text": { "verbosity": "low" },
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "<官方说明原文见代码块下方>",
          "prompt_cache_breakpoint": { "mode": "explicit" }
        }
      ]
    },
    {
      "role": "user",
      "content": "Completed interaction to evaluate..."
    }
  ]
}
官方 text 字段原文是下面这句话(这里只为排版折行,单词未改):
Judge whether the completed interaction provides
evidence that the user is satisfied. Return true
or false. Full grading rubric and labeled
few-shot examples...
这段 JSON 来自:
https://developers.openai.com/api/docs/guides/prompt-caching
官方还提到:有部署按这些原则运行后,曾报告约 70% 的 token 缓存命中率。这是官方写明的「可能结果」,实际上限取决于你的上下文和使用方式,不要把它当成承诺。
把这段 JSON 存成 judge_cache.json 后,可以用 curl 发给 Responses API。若前缀不足 1,024 个可见输入 tokens,请求仍可能正常返回,但不要指望这次就出现缓存写入或命中。
curl "https://api.openai.com/v1/responses" \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer $OPENAI_API_KEY" \
    -d @judge_cache.json
第 5 步:按官方五步流程完成一次函数调用
「Using GPT-6.2」写明:GPT-6.2 Astra 和 GPT-6.2 Sol 支持 Chat Completions,但工具调用必须使用 Responses API。官方「函数调用」把流程分成五步:
- 在请求里向模型声明可用的工具
- 收到模型返回的工具调用
- 在你的应用里执行对应代码
- 把工具输出送回模型
- 收到最终回答,或再进入新的工具调用
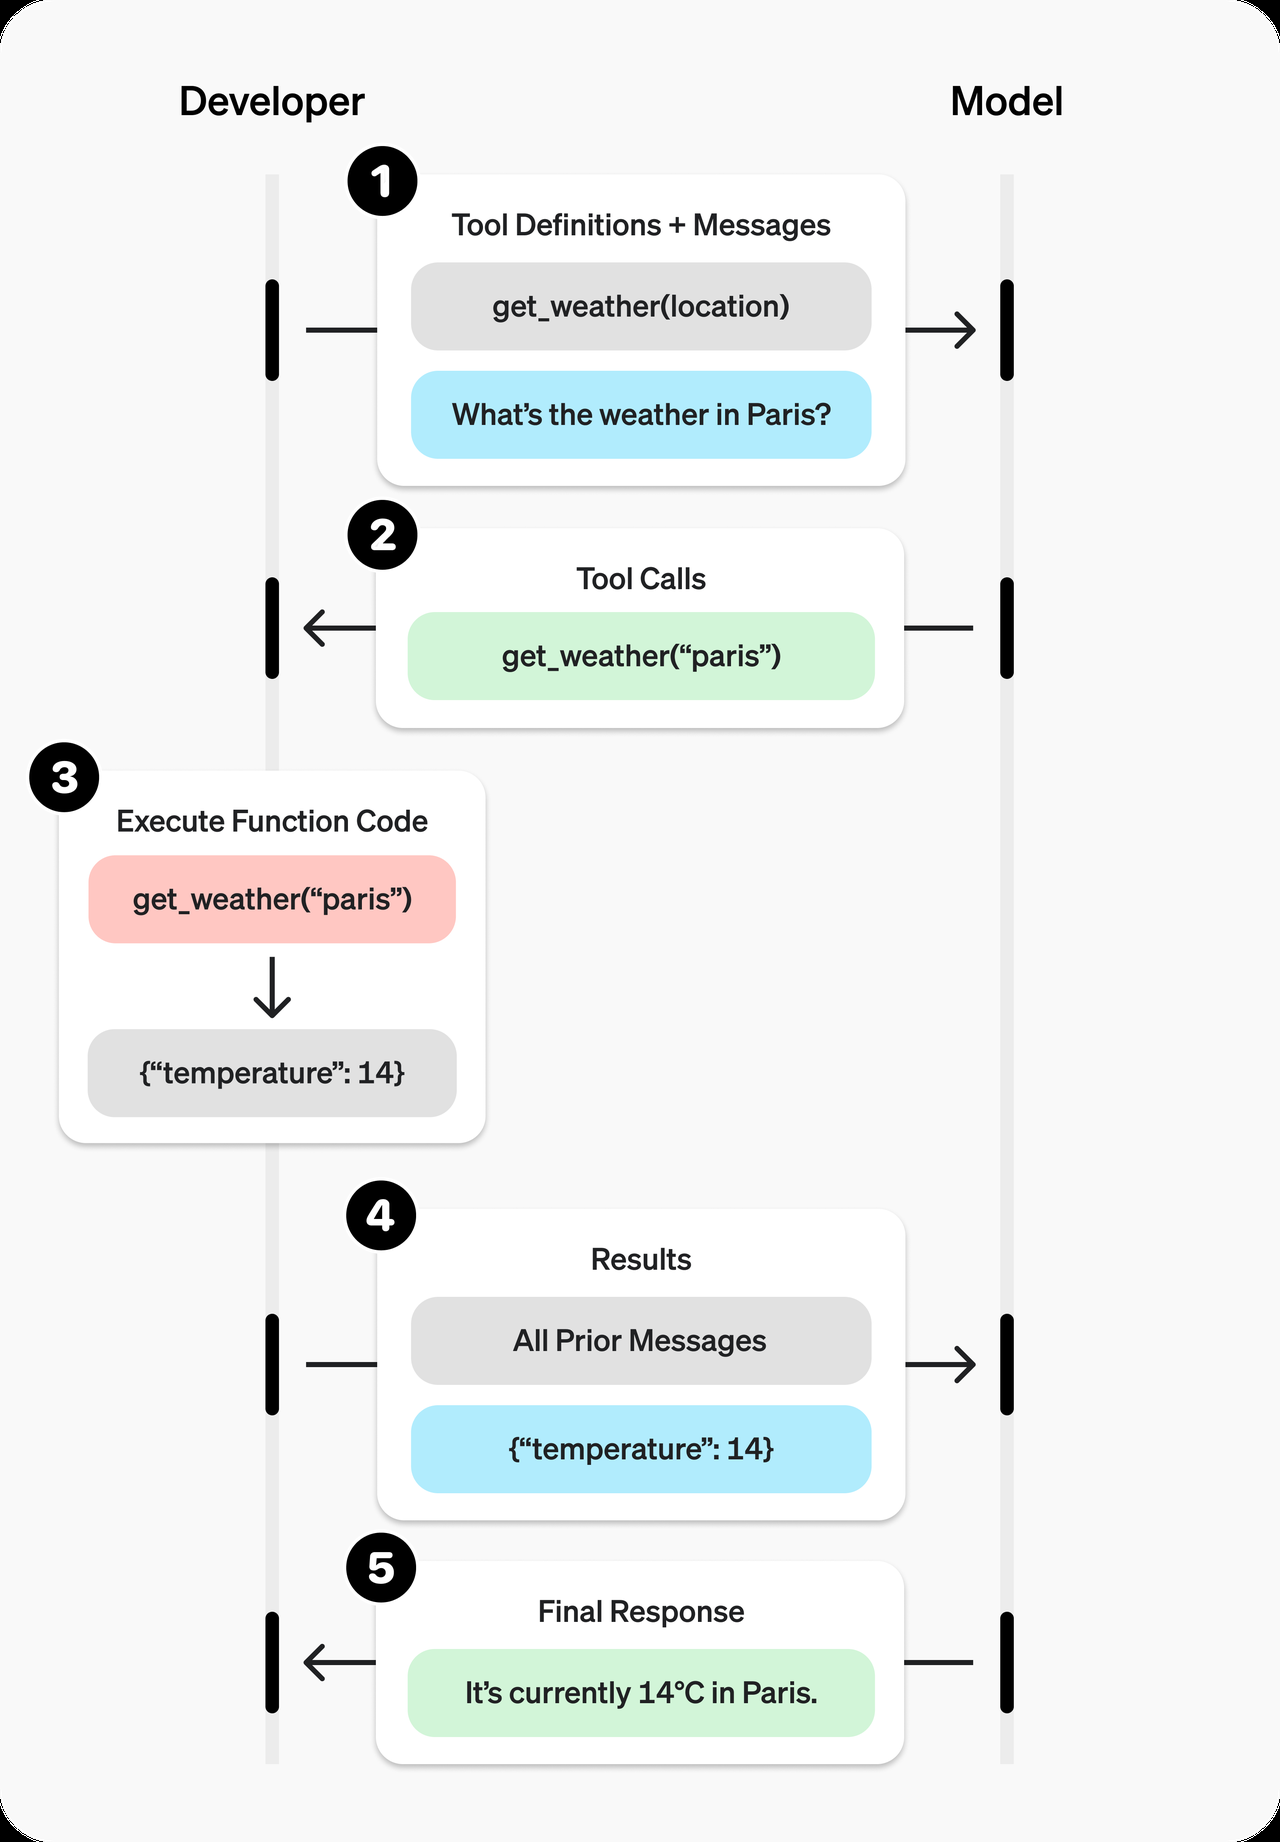
官方原图,来源:
https://cdn.openai.com/API/docs/images/function-calling-diagram-steps.png
下面是官方「Function tool example」的 Python 示例,工具名是 get_horoscope,型号是 gpt-6.2-astra。新建 horoscope.py,整段可以原样复制:
from openai import OpenAI
import json

client = OpenAI()

# 1. Define a list of callable tools for the model
tools = [
    {
        "type": "function",
        "name": "get_horoscope",
        "strict": True,
        "description": "Get today's horoscope for an astrological sign.",
        "parameters": {
            "type": "object",
            "properties": {
                "sign": {
                    "type": "string",
                    "description": "An astrological sign like Taurus or Aquarius",
                },
            },
            "required": ["sign"],
            "additionalProperties": False,
        },
    },
]


def get_horoscope(sign):
    return f"{sign}: Next Tuesday you will befriend a baby otter."


# Create a running input list we will add to over time
input_list = [
    {"role": "user", "content": "What is my horoscope? I am an Aquarius."}
]

# 2. Prompt the model with tools defined
response = client.responses.create(
    model="gpt-6.2-astra",
    tools=tools,
    input=input_list,
)

# Save function call outputs for subsequent requests
input_list += response.output

for item in response.output:
    if item.type == "function_call":
        if item.name == "get_horoscope":
            # 3. Execute the function logic for get_horoscope
            sign = json.loads(item.arguments)["sign"]
            horoscope = get_horoscope(sign)

            # 4. Provide function call results to the model
            input_list.append(
                {
                    "type": "function_call_output",
                    "call_id": item.call_id,
                    "output": horoscope,
                }
            )

response = client.responses.create(
    model="gpt-6.2-astra",
    instructions="Respond only with a horoscope generated by a tool.",
    tools=tools,
    input=input_list,
)

# 5. The model should be able to give a response!
print(response.output_text)
python horoscope.py
这里有两处可以对照、也不应写过的地方。第一,工具函数的返回值在官方示例里是固定的:若 sign 为 Aquarius,函数会返回:
Aquarius: Next Tuesday you will befriend a baby otter.
第二,官方文档没有给出模型最终 output_text 的固定样句,本课不编造。成功时,你应先在第一次响应的 output 里看到 type 为 function_call 的项,再在第二次响应里看到基于上述工具输出写成的最终回答。
注意:第二次请求把「只根据工具结果回答」写在了顶层 instructions 里。结合第 1 步,这正是「只对当前这一轮有效」的用法;稳定的工具定义则每次都通过 tools 传入,并应保持不变,以便前缀可被缓存。
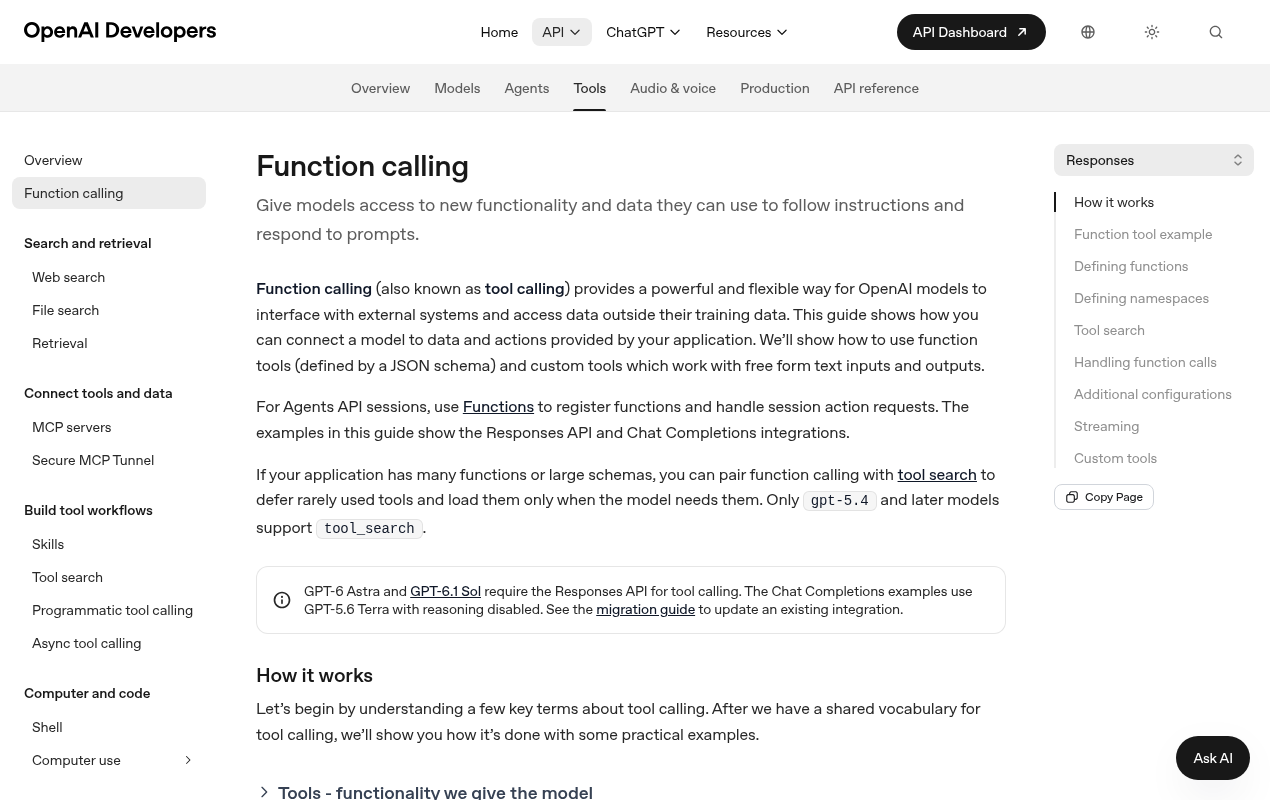
2026-11-19 实拍。
https://developers.openai.com/api/docs/guides/function-calling
第 6 步:迁到 GPT-6.2 时不要再传这些参数
除了推理力度和工具调用接口,官方「Using GPT-6.2」还列出这些迁移要点:
- Chat Completions 请求不要再传
temperature、top_p、logprobs、top_logprobs - Responses 请求不要再传
temperature、top_p、top_logprobs,并从include里去掉message.output_text.logprobs - 缓存相关:稳定说明改放到
developer消息;从 GPT-5.5 或更早型号迁来时,用prompt_cache_options.ttl设为"30m",替换prompt_cache_retention - 两个型号都支持美国和欧盟的数据驻留,以及 Standard、Fast、Batch;Ultrafast 只支持美国数据驻留
- 经批准的组织可在符合条件的接口上使用 Zero Data Retention。启用后,Responses API 会把
store视为false;多轮对话需要按顺序回传此前的输出项,包括加密的推理项。具体资格以官方「Zero Data Retention」为准
本课不展开数据驻留和 ZDR 的开通流程,这两项都因账号而异,需要对照官方文档办理。
常见坑
- 继续把系统提示只写在顶层
instructions。在 GPT-6.2 里,它会被追加到input之后,并按未缓存输入计费。 - 前缀不到 1,024 个可见输入 tokens,却以为一定能看到
cache_write_tokens或cached_tokens。 - 用 Chat Completions 给 GPT-6.2 做工具调用。官方要求改走 Responses API。
- 中途改写已经发给模型的历史消息、工具调用或开发者说明,导致推理项被丢弃、缓存前缀也无法复用。
- 迁代码时仍保留
temperature或top_p。官方已把它们列为 GPT-6.2 迁移时不应再传的参数。
小结
到这里,你已经按官方文档调通了 GPT-6.2 的第一个 Responses 请求,选对了 Astra 或 Sol 和推理力度,也知道该把可复用说明放进缓存前缀,并完成了一次官方工具调用。之后若要加 Web Search、Code Interpreter 或 Multi-agent,请直接从对应的官方指南继续,不要依赖未核对的二手帖。