第 2 课
配对多机、观察跨节点路由并接入应用
用六位 PIN 配对第二台节点,准备相同模型,发送请求并在 Overview Jobs 中确认 Ran on,再按官方约束把应用指向本机环回端点。
学习位置仅保存在当前浏览器,有效期 180 天。
图文讲义
上一课已在单机打通「Endpoints → curl」。本课按官方流程把第二台受信设备加入集群,让独立请求可以落到空闲节点,再把日常应用接到本机环回代理,并记住 PAIR 的安全边界。
官方来源
步骤 1:配对前再确认三件事
目标:避免因网络或重复界面导致配对失败。
操作
- 两台机器都已安装并打开 PAIR(桌面版或各自的
nvpair,不要在同一台混用两套界面) - 它们在同一 受信局域网。只在设备与网络都可信时配对;六位 PIN 是短期引导码
- 「出活」节点上引擎已启动,并准备好与请求相同的模型名(跨机演示时建议两台都放同一模型)
安全边界:共享或不受信网络请先读 SECURITY.md,再决定是否配对。
预期结果
- 两台 PAIR 均已运行;网络互通;模型名计划一致
排错
- 发现不到对端:先确认同一局域网与防火墙,再改用 IP 添加(步骤 2)
步骤 2:用六位 PIN 配对(桌面版)
目标:第二台出现在 Connected nodes / Members。
操作
在已在集群中的机器上:
- 点右上角 Add node;或打开 Settings → Cluster,使用 Available nodes to add
- 选择发现到的系统;发现不到则改用 IP 地址 添加
- PAIR 显示 六位 PIN 并发送邀请
- 在被邀请机器上接受 Cluster invitation,输入同一 PIN
- 打开 Settings → Cluster,确认对端出现在 Connected nodes;Overview 也应可见
- 从任意集群成员重复上述步骤即可继续加节点
终端界面:邀请方在 Nodes(第 3 页签)选中目标后按 i,把 PIN 告诉对方;或 Cluster(第 7 页签)按 i 输入 host / host:port。接受方看到 invite received 后按 a,输入 PIN 回车。完成后 Members 会出现对端。
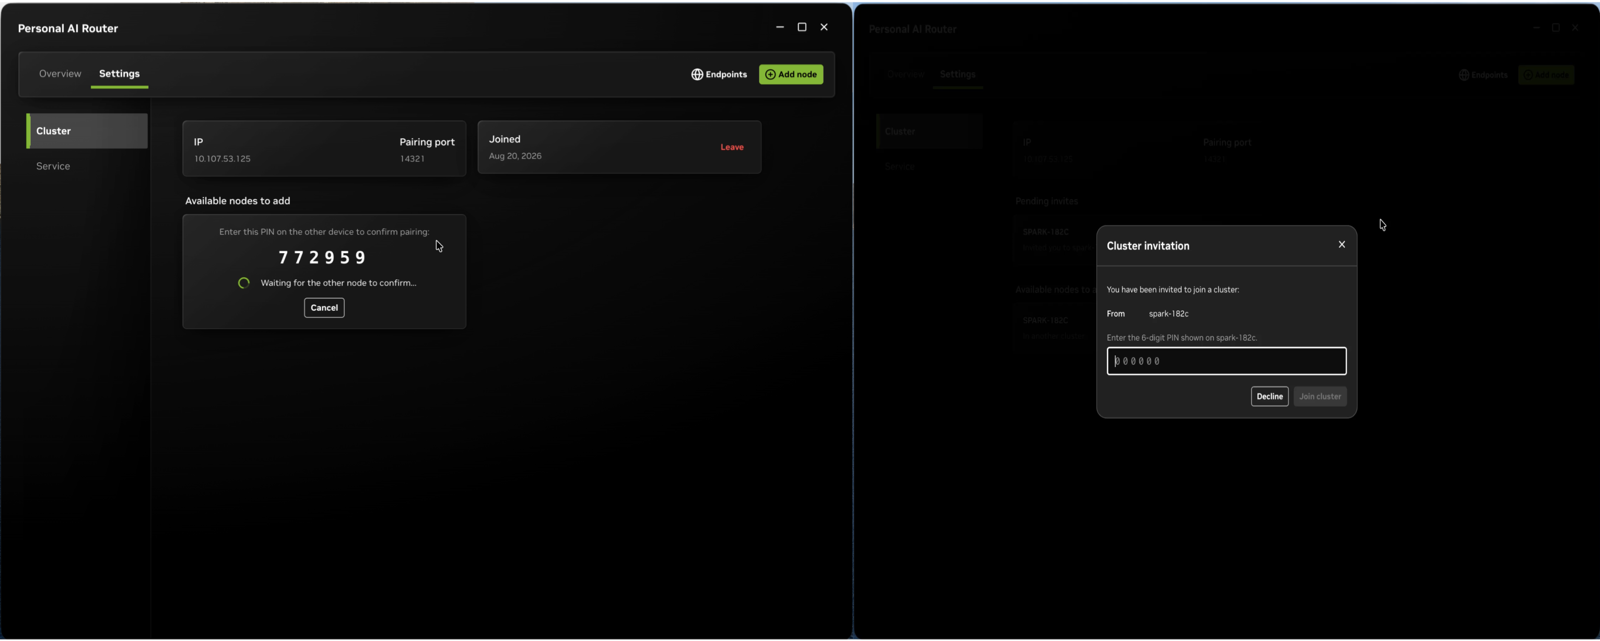
看哪里:六位 PIN 与邀请状态;预期双方在短时窗口内输入同一 PIN。
预期结果
- Connected nodes / Members 列表出现对端主机名
排错
- PIN 过期:重新发起邀请,立即输入
- 同机混用桌面 +
nvpair:先退出其中一套再试
步骤 3:在第二台准备相同模型
目标:至少两台都具备同一模型,才能观察跨节点路由。
操作
对每一台应参与服务的节点:
- Overview 选中该节点 → 引擎设置
- 启动引擎 → Add model → 下载 与第一台相同 的模型名 → 必要时 Load
只有「在线 + 引擎运行 + 本地有该模型」的节点才会被选中。
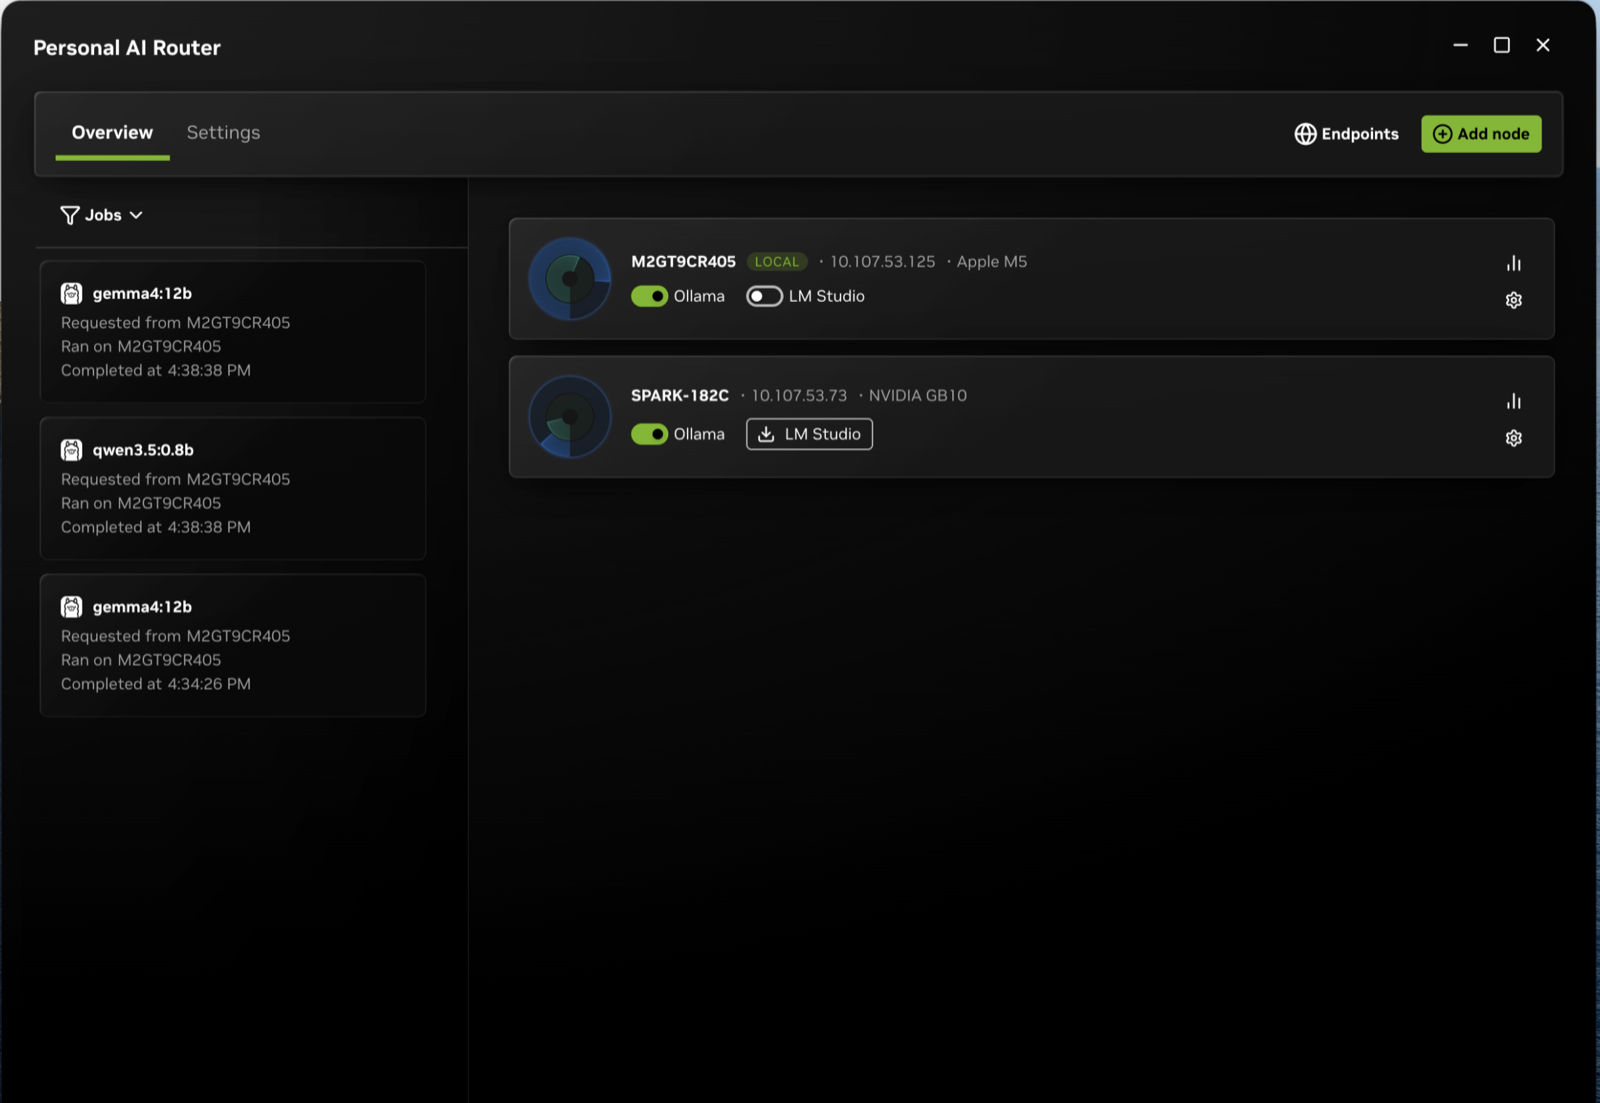
看哪里:Overview 出现两个(或以上)节点卡片;预期对端在线且引擎可进入。
预期结果
- 两台节点均显示引擎 running,且模型名字符串一致
排错
- 只在一台有模型:跨机演示时请求只会落在有模型的那台
步骤 4:再发请求,确认 Ran on 可能换机
目标:用本机环回代理发多次请求,在 Jobs 观察路由结果。
操作
仍在 运行应用的那台机器上,用上一课的 {PAIR_BASE_URL}(本机环回)发送:
curl {PAIR_BASE_URL}/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "{MODEL_NAME}",
    "messages": [
      {
        "role": "user",
        "content": "用三句话说明什么是本地推理路由。"
      }
    ]
  }'
连续多发几次(可开两个终端并行),在 Overview 打开 Jobs,阅读 Ran on / Running on。
终端界面可到 Workloads(第 5 页签)看实时负载;Proxies(第 4 页签)中 selected=auto 表示自动路由(排障单机前保持自动)。
安全边界:每次请求仍只在一台机器上跑完,不是模型并行分片,也不是合并显存。
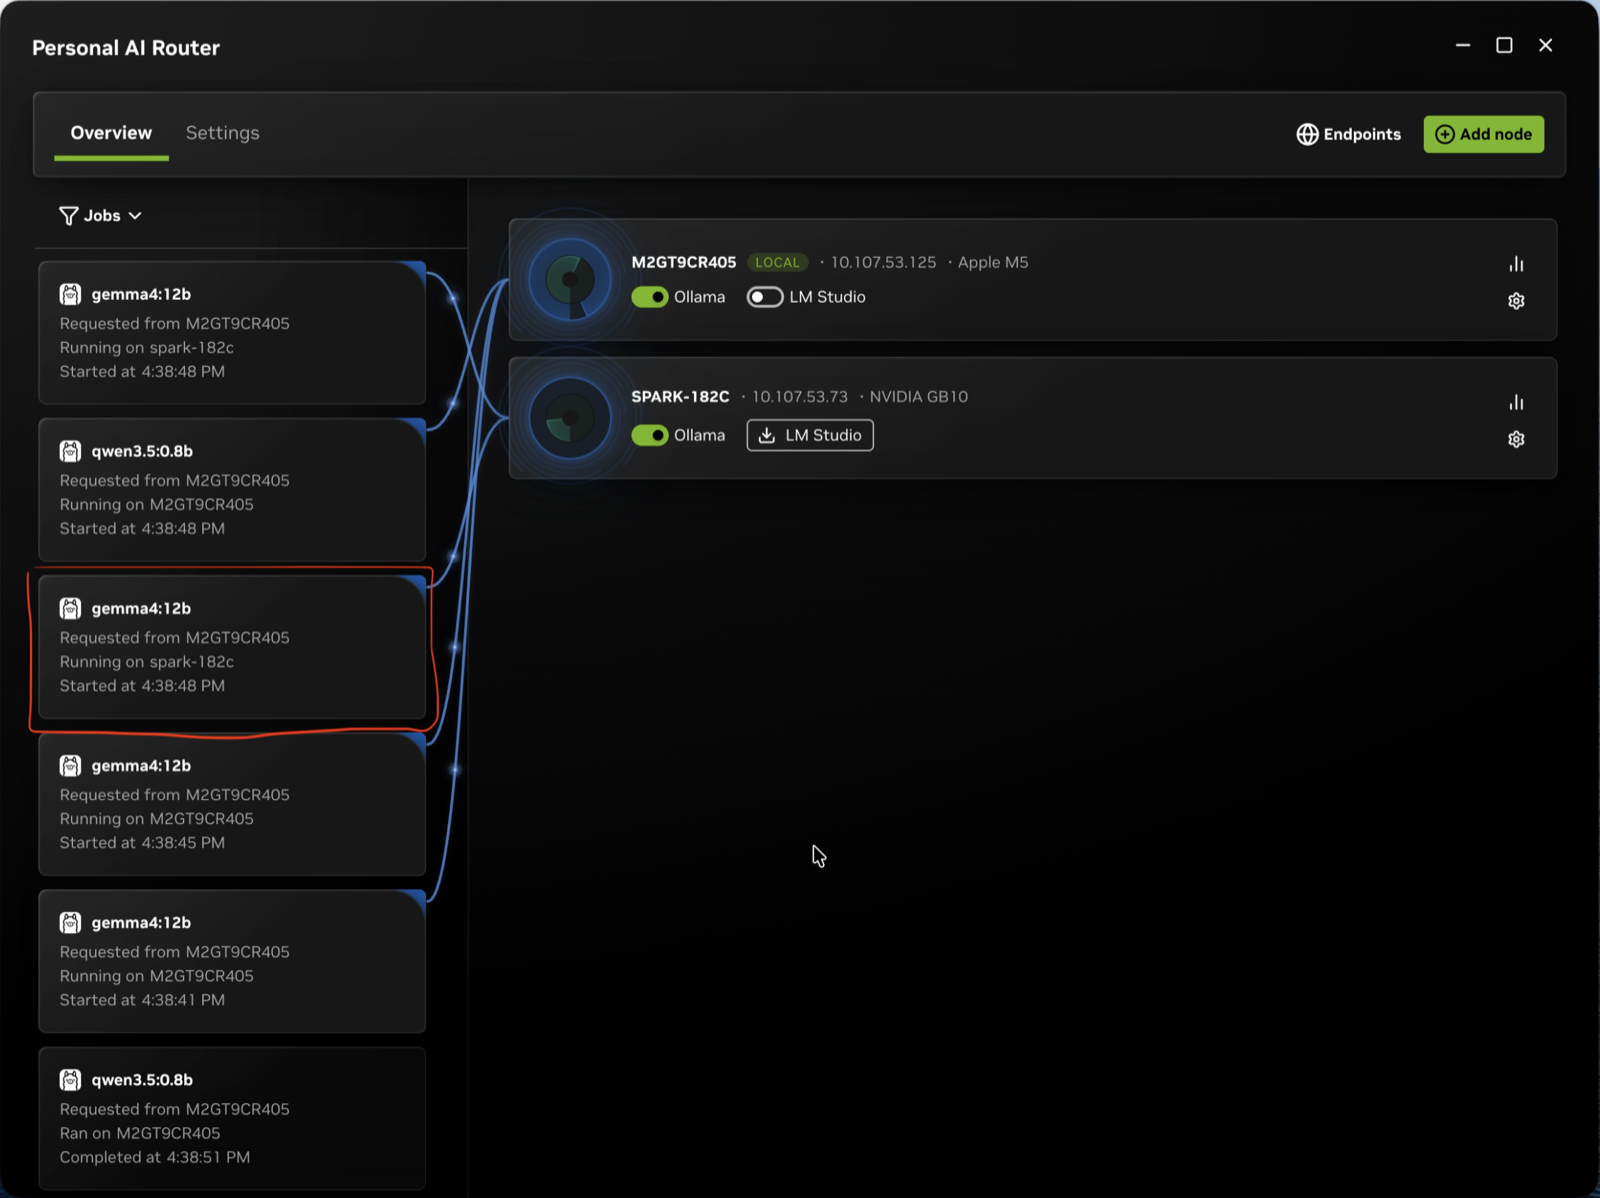
看哪里:Jobs 卡片上的 Ran on / Running on;预期不同任务可能落在不同 Connected 节点。
预期结果
- 回复正常
- 不同任务可能落在不同 Connected 节点(取决于负载与模型在位)
排错
- 始终同一节点:确认第二台模型与引擎就绪,并提高并发后再观察
步骤 5:把应用接到本机 PAIR 端点
目标:把日常应用的 Base URL 指到本机环回代理。
操作
- 在 运行该应用的电脑上安装并加入同一集群(该电脑甚至可以没有 GPU——只要集群里别的节点能服务)
- 将应用的 Base URL / API Base 设为该电脑 Endpoints 里复制的地址,例如:
http://127.0.0.1:11434
或
http://127.0.0.1:1234
- 模型名填集群里已准备好的精确名称
安全边界:PAIR 只接受来自本机环回的明文请求。对类似局域网主机名:端口的网络明文访问会返回 403。PAIR 不提供可从局域网直连的明文推理入口。若自行把引擎监听改到非环回地址,属于 PAIR 之外的暴露,风险自负。应用、模型来源、引擎与配对节点都在本地时,提示与回复意图保持在局域网内。
预期结果
- 应用能正常聊天 / 补全
- 未把明文推理口暴露到局域网
排错
- 收到 403:把 Base URL 改回本机
127.0.0.1,不要用对端局域网 IP 做明文推理入口
步骤 6:端口与防火墙速查
目标:了解集群节点间通信端口,必要时放行受信节点。
操作
集群节点间通信(官方 Port reference):
5353/udp— mDNS 发现14318— 节点硬件与模型清单14319— 服务错误同步14320— 工作负载传播14321— 配对与集群成员14322— 向对端提供模型列表14323— 集群范围远端引擎控制
Windows 安装器会加规则;若 Linux 防火墙较严,请在受信节点之间放行上表端口。
改本机代理端口:Overview → 本机 Engine settings → Ports → 编辑 Proxy/Server → Apply ports。改完后更新应用 Base URL;Endpoints 始终显示当前值。
预期结果
- 配对与跨节点 Jobs 正常;如曾改端口,应用 Base URL 已同步
排错
- 发现失败:先查 mDNS
5353/udp与局域网隔离策略
步骤 7:SSH / 无桌面场景保活
目标:SSH 断开后节点仍继续服务。
操作
tmux new -s pair
nvpair
# 分离:Ctrl-b d
# 恢复:tmux attach -t pair
预期结果
- 分离会话后,对端仍能把任务路由到该节点
排错
- 忘记 tmux:SSH 退出会导致终端界面退出、节点停止服务
步骤 8:本课检查清单
- 第二台出现在 Connected nodes / Members
- 两台(或以上)具备同一模型且引擎 running
- 多次
curl后 Jobs 能看到任务,必要时观察到不同 Ran on - 应用只指向 本机
127.0.0.1代理,未把明文推理口暴露到局域网 - 已阅读 SECURITY.md「Inference Endpoints Are Loopback-Only」一节
清理(回滚)
按官方建议需要时可:
- 移除配对
- 卸载 PAIR
- 删除不再需要的引擎或模型
本课配图来自 NVIDIA Personal AI Router 官方文档(配对 PIN、双节点 Overview、Jobs),版权归 NVIDIA。