第 2 课
思维链摘要与加密,再让模型读一张官方示例图
用流式输出分开打印思考和回答,用 reasoning_effort 选择强度;打开 thinking_display=summarized,在「17×23」和「再加 9」两轮中回传密文;再把官方示例图传给 qwen4-max,对照官方看图描述。
课程目录第 2 / 3 课
学习位置仅保存在当前浏览器,有效期 180 天。
思维链摘要与加密,再让模型读一张官方示例图
本课对照官方文档「深度思考」「思维链摘要与加密」「图像与视频理解」编写。流式思考的对照输出、官方示例图的描述均来自上述文档;多轮密文回传的代码按官方示例整理。2026-11-18 核对。
本课目标
- 用流式输出分开打印思考过程和最终回答
- 用
reasoning_effort选择思考强度 - 打开思维链摘要与加密,在第二轮原样回传密文
- 把官方示例图传给
qwen4-max,完成一次看图问答
前置条件
- 已完成第 1 课,当前终端里仍有
DASHSCOPE_API_KEY和WORKSPACE_ID - 已安装
openai包 - 能访问公网图片地址(官方示例图托管在阿里云文档的静态域名上)
第 1 步:流式分开打印思考和回答
qwen4-max 属于混合思考模式,默认开启思考。思考内容在 reasoning_content,回答在 content。官方「深度思考」建议用流式调用,便于一边生成一边看,也避免长时间同步等待。
新建 think_stream.py。下面是官方示例,只把 Base URL 改成从环境变量读取:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=(
        f"https://{os.getenv('WORKSPACE_ID')}"
        ".cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
    ),
)

messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True,
    stream_options={"include_usage": True},
)

reasoning_content = ""
answer_content = ""
is_answering = False
print("\n" + "=" * 20 + "思考过程" + "=" * 20 + "\n")

for chunk in completion:
    if not chunk.choices:
        print("\nUsage:")
        print(chunk.usage)
        continue

    delta = chunk.choices[0].delta
    if (
        hasattr(delta, "reasoning_content")
        and delta.reasoning_content is not None
    ):
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
        reasoning_content += delta.reasoning_content

    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20 + "\n")
            is_answering = True
        print(delta.content, end="", flush=True)
        answer_content += delta.content
python3 think_stream.py
官方文档给出的对照输出如下。你看到的句子不会逐字相同,但应先出现「思考过程」,再出现「完整回复」,最后一块带 usage:
====================思考过程====================

好的,用户问“你是谁”,我需要给出一个准确且友好的回答。首先,
我要确认自己的身份,
即千问,由阿里巴巴集团旗下的通义实验室研发。接下来,
应该说明我的主要功能,
比如回答问题、创作文字、逻辑推理等。同时,要保持语气亲切,
避免过于技术化,
让用户感觉轻松。还要注意不要使用复杂术语,确保回答简洁明了。
另外,可能需要加入一些互动元素,
邀请用户提问,促进进一步交流。最后,检查是否有遗漏的重要信息,
比如我的中文名称“千问”和英文名称“Qwen”,
以及所属公司和实验室。确保回答全面且符合用户期望。
====================完整回复====================

你好!我是千问,是阿里巴巴集团旗下的通义实验室自主研发的超大规模
语言模型。
我可以回答问题、创作文字、进行逻辑推理、编程等,
旨在为用户提供高质量的信息和服务。
你可以叫我Qwen,或者直接叫我千问。有什么我可以帮你的吗?
最后那块 usage 里,输出 Token 包含思维链。若只想关思考,把 extra_body 改成 {"enable_thinking": False},终端里就不应再出现「思考过程」里的长段推理。
第 2 步:用 reasoning_effort 选择思考强度
官方模型页为 Qwen4-Max 给出的思考强度如下(Chat Completions / DashScope):
| 参数 | 可选值 | 默认 | 映射 |
|---|---|---|---|
reasoning_effort | low、high、xhigh | high | minimal→low;medium→high;max→xhigh |
Responses 协议写的是 reasoning.effort,Anthropic Messages 写的是 output_config.effort。本课继续用 Chat Completions,所以在 Python 里把它放进 extra_body。
想先快速试连通,把第 1 步脚本里的 extra_body 改成:
extra_body={
    "enable_thinking": True,
    "reasoning_effort": "low",
},
复杂推理再改回 high,或试 xhigh。官方同时列出默认 thinking_budget=131072,用来限制思维链的最大 Token 数,超过后模型开始输出回复。普通练习不必改预算;若只是怕一次想太久,优先用 reasoning_effort="low",或直接 enable_thinking=False。
第 3 步:打开思维链摘要与加密
默认情况下,接口会返回完整思维链明文。官方「思维链摘要与加密」页说明:开启本功能后,原始思维链不再以明文返回,改为同时给出摘要和完整密文。摘要用于展示,密文用于在后续轮次恢复历史思考。适用模型就是 qwen4-max。
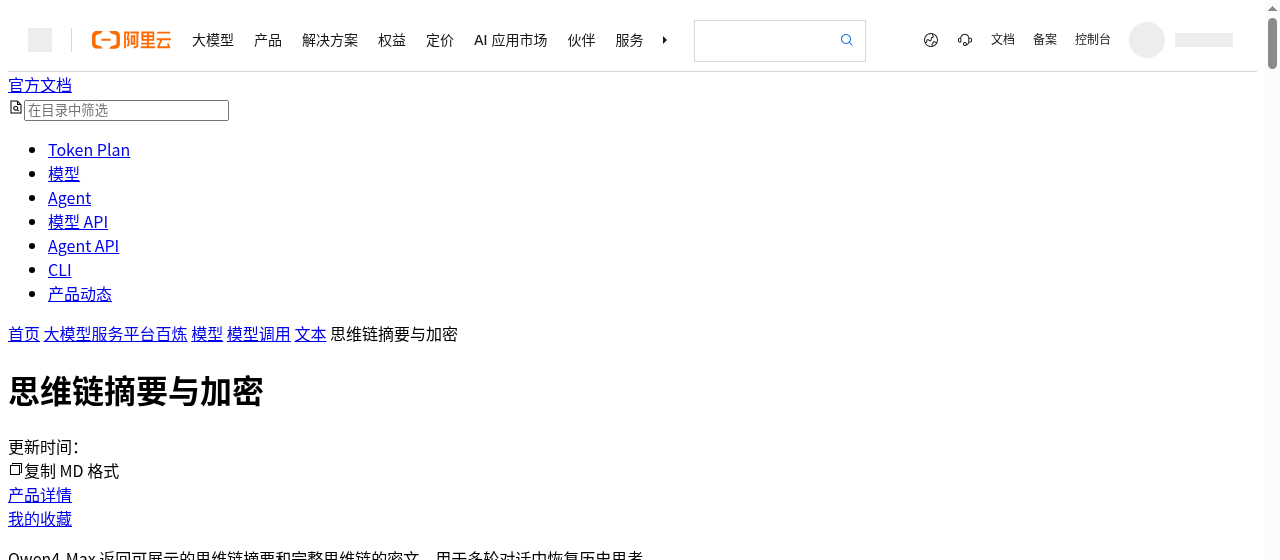
2026-11-18 用无头浏览器对下面这个地址实拍,并裁掉页脚未排完的区域。
Chat Completions 的关键字段是:
| 作用 | 参数或字段 |
|---|---|
| 开启 | thinking_display="summarized",并保持 enable_thinking=true |
| 摘要 | choices[i].message.reasoning_content |
| 密文 | choices[i].message.encrypted_content |
| 多轮续推 | 每轮都开启本功能,设 preserve_thinking=true,原样回传密文 |
官方还提醒:摘要或密文可能缺失;未产生思考或加密失败时,接口仍不返回原始思维链。密文一次返回,不要因为文本为空就过滤掉这一帧,也不要为密文单独再造一条 assistant 消息。
用 curl 先看一轮(官方示例,计算 17×23):
API="https://${WORKSPACE_ID}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
curl -X POST "$API/chat/completions" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen4-max",
  "messages": [
    {
      "role": "user",
      "content": "请计算 17×23。"
    }
  ],
  "enable_thinking": true,
  "thinking_display": "summarized",
  "preserve_thinking": true
}'
对照时请盯三个地方:content 应给出 391;reasoning_content 是一段可读的摘要,而不是第 1 步那样完整的逐步推理;encrypted_content 是一长串密文。本功能不额外收费,按模型原有输入、输出规则计费。
第 4 步:第二轮把密文原样传回去
官方多轮示例的两个问题是「请计算 17×23。」和「再加 9。」。第二轮必须把上一轮 assistant 消息(含密文)完整放进 messages。Python SDK 里,enable_thinking、thinking_display、preserve_thinking 都走 extra_body。
新建 cot_multiturn.py:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url=(
        f"https://{os.environ['WORKSPACE_ID']}"
        ".cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
    ),
)
questions = [
    "请计算 17×23。",
    "再加 9。",
]
history = []

for turn, question in enumerate(questions, start=1):
    history.append({"role": "user", "content": question})
    response = client.chat.completions.create(
        model="qwen4-max",
        messages=history,
        max_tokens=8192,
        stream=False,
        extra_body={
            "enable_thinking": True,
            "thinking_display": "summarized",
            "preserve_thinking": True,
        },
    )
    assistant_message = response.choices[0].message.model_dump(
        exclude_none=True
    )
    history.append(assistant_message)
    print(f"Turn {turn}")
    print("Summary:", assistant_message.get("reasoning_content", ""))
    print("Answer:", assistant_message["content"])
    print(
        "Has cipher:",
        "encrypted_content" in assistant_message,
    )
python3 cot_multiturn.py
官方文档没有提供这两轮的逐字摘要,但任务本身可以核对:第一轮答案应是 391,第二轮应在 391 上再加 9,得到 400。摘要文字每次都会不同;密文不要改、不要截断。官方写明:回传历史时保留完整密文,摘要可以省略。文本和多模态输入使用同一组参数;密文只保存思维链,图片等历史输入仍要保留在 messages 里。
第 5 步:让模型读一张官方示例图
qwen4-max 原生支持看图,不必再换一个 VL 型号。官方「图像与视频理解」快速开始用的就是这个模型,示例图地址也是官方文档提供的:
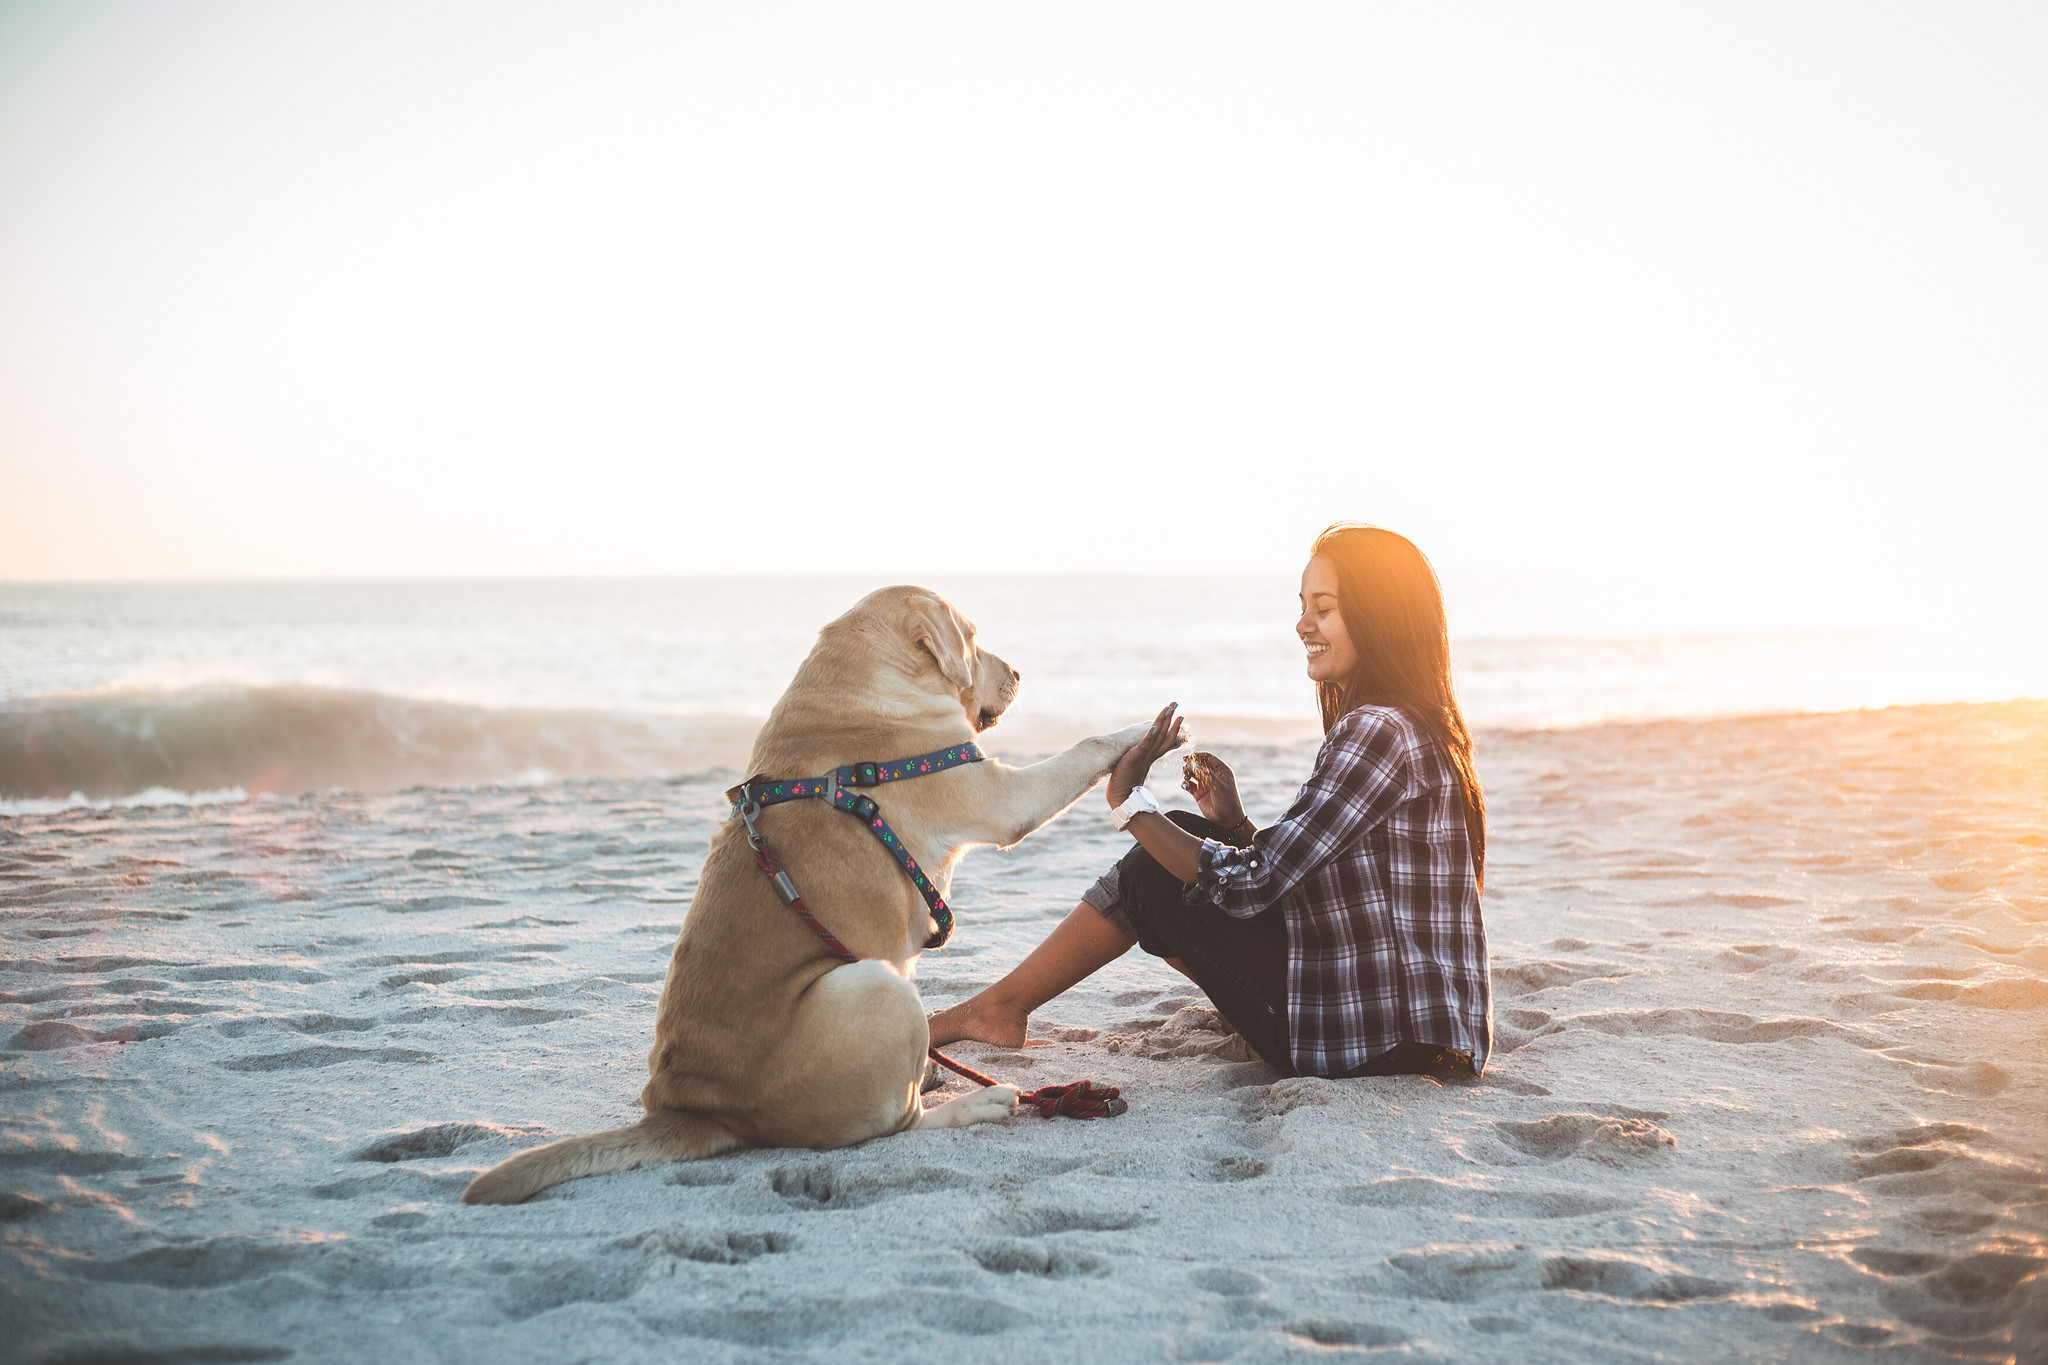
官方文档「图像与视频理解」使用的示例图,2026-11-18 从上面这个地址原样下载,未做修改。
2026-11-18 用无头浏览器对下面这个地址实拍,并裁掉页脚未排完的区域。
新建 look_image.py。代码按官方 Python 示例,只改 Base URL 的读取方式:
import os
from openai import OpenAI

IMAGE_URL = (
    "https://help-static-aliyun-doc.aliyuncs.com/"
    "file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"
)

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=(
        f"https://{os.getenv('WORKSPACE_ID')}"
        ".cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
    ),
)

completion = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {"url": IMAGE_URL},
                },
                {"type": "text", "text": "图中描绘的是什么景象?"},
            ],
        },
    ],
)
print(completion.choices[0].message.content)
python3 look_image.py
官方给出的对照结果是:
这是一张在海滩上拍摄的照片。照片中,一个人和一只狗坐在沙滩上,
背景是大海和天空。人和狗似乎在互动,狗的前爪搭在人的手上。
阳光从画面的右侧照射过来,给整个场景增添了一种温暖的氛围。
你得到的句子不必逐字相同,但应能看出:海滩、人和狗、手与前爪的互动、阳光。若要同时看思考摘要,把第 3 步的 extra_body 加进这次请求即可,官方写明文本和多模态输入使用相同参数。
本地文件的上传方式、像素上限和 detail / max_pixels 见同一篇官方文档,本课不展开。视频理解把 type 换成 video_url,并传入视频地址,本课也不要求跟做,以免一次消耗过多免费额度。
常见坑
- 开启摘要后仍去找完整思维链明文。这时
reasoning_content已经是摘要,完整内容在密文里,接口不会再给出原文。 - 多轮时只回传了摘要,或把
encrypted_content截断、改写。官方要求每轮都开启本功能,并原样回传密文。 - 流式处理时丢掉「文本为空」的帧,结果把密文帧过滤掉了。
- 图片地址必须是模型服务能访问的公网 URL,或按官方说明改走本地文件上传,不能只用你电脑上的相对路径。
- 继续走旧的 DashScope 域名。新特性请用第 1 课的业务空间专属域名。
小结
你已经能分开看思考和回答,会用 reasoning_effort 调节强度,也能打开思维链摘要与加密并在第二轮回传密文,最后用官方示例图完成了一次看图问答。下一课用 Qwen4 的显式缓存,给长前缀打上断点,对照创建和命中时的 usage 与费用。