第 3 课
用 Qwen4 显式缓存复用长前缀,对照创建与命中计费
分清隐式缓存、手动断点和自动缓存;用 prompt_cache_breakpoint 连续请求两次并读懂 usage;按北京官方单价估算 5m 缓存费用,再按需设置 TTL 或打开自动缓存。
课程目录第 3 / 3 课
学习位置仅保存在当前浏览器,有效期 180 天。
用 Qwen4 显式缓存复用长前缀,对照创建与命中计费
本课对照官方文档「显式缓存(Qwen4)」和「模型调用价格」编写。创建与命中的 usage 字段、示例数字来自官方文档;费用按北京地域官方单价推算。2026-11-18 核对。
本课目标
- 分清隐式缓存、手动断点和自动缓存
- 用
prompt_cache_breakpoint给长前缀打上断点,连续请求两次,对照 usage - 按官方单价估算创建缓存和命中缓存的费用
- 知道 TTL(
5m/1h)和自动缓存该怎么开
前置条件
- 已完成第 1 课,当前终端里仍有
DASHSCOPE_API_KEY和WORKSPACE_ID - 已安装
openai包 - 本课示例按官方做法关闭思考,避免思维链干扰对输入缓存的观察
第 1 步:先分清三种缓存
在多轮对话、长文档问答和 Agent 里,后面几次请求往往带着同一段系统提示、工具说明或参考文档。显式缓存就是把这段公共前缀存下来,命中之后不必重复计算,从而降低延迟和输入成本。
官方把关系写得很清楚:
- 隐式缓存:不设任何缓存参数时,系统自动识别公共前缀,不保证命中。
- 显式缓存(手动断点):在内容块上标记断点,前缀完全相同且在有效期内,命中是确定的。
- 自动缓存:Qwen4 的进阶用法,由系统在输入末尾自动设断点,按显式缓存的 TTL 和计费规则处理。它和「什么参数都不传」的隐式缓存不是一回事。
本课的能力只适用于 Qwen4 系列。缓存前缀至少 1,024 Token,不足时请求仍会正常返回,但不会创建缓存。每个请求最多保留最后 4 个有效断点。TTL 只能是 5m 或 1h,默认 5m。
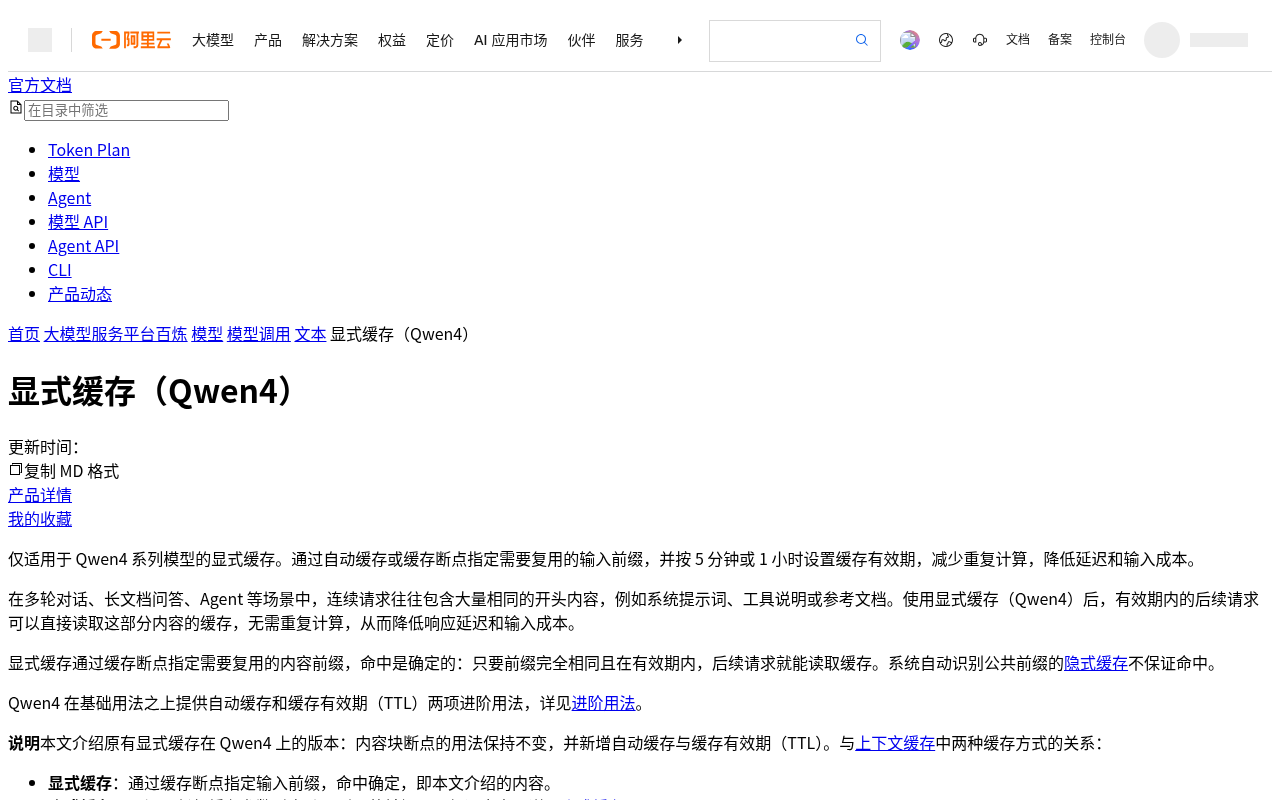
2026-11-18 用无头浏览器对下面这个地址实拍。
https://help.aliyun.com/zh/model-studio/explicit-cache-qwen4
新接入请用 prompt_cache_breakpoint。旧的 "cache_control": {"type": "ephemeral"} 仍然兼容,且同一用户的相同前缀可以在两种标记之间复用;官方警告同一请求里不要混用这两种写法。
国际站 QwenCloud 文档写明:DashScope 原生接口不支持 Qwen4 的新版显式缓存。本课只用 OpenAI 兼容 Chat Completions。
第 2 步:给长前缀打上断点,连续请求两次
官方基础用法:在需要复用的内容块末尾设断点,从请求开头到该处的全部输入就是缓存前缀。第一次创建缓存,有效期内前缀相同的后续请求读取缓存。断点之后的问题每次都可以换。
新建 explicit_cache.py。下面是官方示例,只把 Base URL 改成从环境变量读取:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=(
        f"https://{os.getenv('WORKSPACE_ID')}"
        ".cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
    ),
)

# 需要复用的长文档,缓存前缀最少为 1024 Token
long_text = "<固定的长文档>" * 400

def ask(question):
    completion = client.chat.completions.create(
        model="qwen4-max",
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": long_text,
                        "prompt_cache_breakpoint": {
                            "mode": "explicit"
                        },
                    },
                    {"type": "text", "text": question},
                ],
            }
        ],
        extra_body={"enable_thinking": False},
    )
    return completion.usage.prompt_tokens_details

ask("请概括这份文档。")  # 第一次请求:创建缓存
details = ask("请列出文档的三个要点。")  # 第二次:读取缓存
print(
    f"读取缓存 {details.cached_tokens} Token,"
    f"创建缓存 {details.cache_write_tokens} Token"
)
python3 explicit_cache.py
第二次请求的 cached_tokens 是读取量,cache_write_tokens 是本次创建量。前缀不变时,第二次的 cache_write_tokens 应为 0。官方写明:数字为示意,实际取决于文档长度。
建议顺便把第一次返回也打印出来,对比两次的 prompt_tokens_details。如果两次的 cached_tokens 都是 0,先检查前缀是否满 1,024 Token,以及两次 long_text 是否完全一致(多一个空格都不会命中)。
第 3 步:对照官方 usage,并估算费用
官方「查看缓存用量」给出的,是首次创建缓存时的 usage(纯文本输入、非思考模式):
{
  "usage": {
    "prompt_tokens": 2304,
    "completion_tokens": 128,
    "total_tokens": 2432,
    "prompt_tokens_details": {
      "text_tokens": 2304,
      "cached_tokens": 0,
      "cache_write_tokens": 2048,
      "cache_creation_input_tokens": 2048,
      "cache_type": "ephemeral",
      "cache_creation": {
        "ephemeral_5m_input_tokens": 2048,
        "ephemeral_1h_input_tokens": 0
      }
    },
    "completion_tokens_details": {}
  }
}
字段含义按官方说明:
| 字段 | 含义 |
|---|---|
prompt_tokens | 全部输入,包含读取、创建和未走缓存的部分;命中后这个总数不扣减 |
cached_tokens | 读取缓存的 Token 数 |
cache_write_tokens | 创建缓存的 Token 数 |
cache_creation_input_tokens | 与 cache_write_tokens 相等,统计时不要加两次 |
cache_creation | 按 TTL 拆开的创建量,两项之和等于创建量 |
上例中,未走缓存的输入是 2304 − 0 − 2048 = 256 Token。各缓存字段都是原始 Token 数,不含计费倍率。官方接着写:有效期内以相同前缀再请求时,cached_tokens 为 2048,cache_write_tokens 以及 cache_creation 里两项均为 0,prompt_tokens 仍为 2304。
北京地域 qwen4-max 的缓存单价来自官方价格页(每百万 Token):
| 类型 | 单价 |
|---|---|
| 普通输入(未读也未写缓存) | 10 元 |
| 创建缓存,TTL 为 5m | 12.5 元 |
| 创建缓存,TTL 为 1h | 20 元 |
| 显式 / 隐式缓存命中 | 0.5 元 |
| 输出(思维链 + 回答) | 30 元,不受缓存影响 |
用官方这组 2048 / 256 的数字做估算(只为对公式,不是你的账单):
第一次(创建 5m 缓存):
  写缓存 2048 / 1,000,000 × 12.5 = 0.0256 元
  未缓存  256 / 1,000,000 × 10   = 0.00256 元
  输入小计 0.02816 元

第二次(命中同一前缀):
  读缓存 2048 / 1,000,000 × 0.5  = 0.001024 元
  未缓存  256 / 1,000,000 × 10   = 0.00256 元
  输入小计 0.003584 元
第二次输入费用大约是第一次的 13%。输出仍按 30 元 / 百万 Token 另算。若本次前缀里既有旧缓存又有新增,旧的按读取计费,新增按创建计费。
免费额度按输入加输出的原始 Token 扣减。缓存折扣影响的是按量付费时的金额,不要把「命中很便宜」理解成「不扣免费额度」。
第 4 步:设置 TTL,并按需打开自动缓存
要指定有效期,在请求顶层加 prompt_cache_options。Python SDK 放进 extra_body。例如 5 分钟、只用手动断点:
extra_body={
    "enable_thinking": False,
    "prompt_cache_options": {"mode": "explicit", "ttl": "5m"},
},
需要一小时,把 ttl 改成 "1h"。TTL 只对显式缓存生效。官方常见问题写明:在 Chat Completions 里如果只设置 prompt_cache_options.ttl、既没有手动断点也没有打开自动缓存,请求仍走隐式缓存,有效期不会按你想的变化。
自动缓存是另一条路:系统在输入末尾自动设断点,适合多轮对话,不必自己随着轮次移动断点。开启方法是把 mode 设为 implicit:
extra_body={
    "enable_thinking": False,
    "prompt_cache_options": {"mode": "implicit", "ttl": "5m"},
},
这里的名字容易混,请以官方表格为准:
| 设置 | 自动断点 | 缓存行为 |
|---|---|---|
mode 为 implicit | 设置 | 末尾自动断点和手动断点同时生效 |
mode 为 explicit,有手动断点 | 不设置 | 按手动断点创建或读取 |
mode 为 explicit,无手动断点 | 不设置 | 使用隐式缓存 |
不传、传 null 或 {},或只设 ttl | 不设置 | 有手动断点则按断点,否则隐式缓存 |
官方特别说明:mode 为 implicit 时用的是自动断点,按本文的 TTL 与计费规则处理,和「什么参数都不传」的隐式缓存不同;mode 为 explicit 只表示不自动设断点,并不会关掉隐式缓存。mode 只对当前请求生效。
命中后的续期规则也很具体:新的到期时间取「原到期时间」与「本次开始时间 + 本次 TTL」中较晚的一个,且保留较高档位。因此,用 5m 请求命中 1h 缓存,不会把有效期缩短。若用 1h 请求命中还在有效期内的 5m 缓存,命中部分按 1h 重新创建计费。完整例子见官方「续期规则」。
常见坑
- 前缀不足 1,024 Token,看起来「调用成功」但没有创建缓存,TTL 创建明细也不会返回。
- 只改了断点后面的问题却改动了前面的文档,前缀不再完全相同,第二次无法命中。
- 只设置了
ttl,忘了加手动断点或mode: implicit,结果仍是不保证命中的隐式缓存。 - 同一请求里同时写
prompt_cache_breakpoint和cache_control。 - 把
cache_write_tokens和cache_creation_input_tokens加两次,用量会被算重。 - 用 DashScope 原生接口去打 Qwen4 新版显式缓存。本课请继续用 Chat Completions。
小结
你已经用手动断点走完「第一次创建、第二次命中」的路径,能读懂 cached_tokens 和 cache_write_tokens,也能按官方单价估算 5m 缓存的费用,并知道何时改用自动缓存或把 TTL 调到 1h。到这里,Qwen4-Max 的第一条跟做路径已经走完:调通 API、看懂思考、打开摘要与加密、完成看图,再用显式缓存把长前缀的输入成本降下来。